API网关限流与熔断配置 一线实操的那些取舍
上周跟一个做零售系统的后端喝酒,他说大促当天网关直接被刷爆,不是没配限流,是把全局限流阈值设成了单节点的两倍。
蠢吗?
真不蠢。
很多人第一次配API网关限流与熔断配置,都是从官方文档抄个示例参数就上线,根本没算过自己的服务能扛多少。
限流阈值不是拍脑袋定的数字
说白了限流不是为了把正常用户拦在外面,是给后端服务留够缓冲的空间。很多人上来就配1000QPS,根本不看自己下游的商品服务单实例只能扛200QPS,五个实例满打满算1000QPS,你网关设1000,等于完全没缓冲,稍微有个突发流量,下游直接线程池打满,请求全堆在网关队列里,最后超时雪崩。
很多人喜欢用漏桶,觉得平滑流量好,但是漏桶的问题是,遇到正常的突发流量——比如刚开抢的那一秒,用户集中点进来——会被直接拦掉,反而造成不必要的投诉。令牌桶就灵活点,允许一定程度的突发,但是你得把桶的大小设对,别设太大,不然等于没限流。
我见过最离谱的阈值设置,是把网关的限流设成了服务器带宽的承载上限,完全不考虑应用层的处理能力。带宽够了,应用层CPU打满,请求照样处理不过来,最后还是堆在网关上超时。
熔断不是断网,是给系统留喘气的窗口
很多人对熔断的理解有偏差,觉得只要请求失败率到阈值就断,其实不对。上次碰到个团队,把熔断的失败阈值设成了50%,持续10秒就触发,结果下游服务因为临时网络抖动丢了几个包,刚好卡到50%,直接把整个订单链路熔断了20秒,本来只是几个请求失败,硬生生搞成了全链路不可用。
真的,这事没那么玄。
你得算清楚,你的服务在正常运行时,本身的错误率是多少。比如平时调用第三方支付接口,就有2%的超时率,你要是把熔断阈值设成3%,那等于天天在熔断,完全没法用。
熔断的时间窗口也不是越长越好。很多人觉得触发熔断就等60秒,其实不对,你可以设个半开状态,等个5秒,放一个探测请求过去,如果通了,就逐步恢复流量,不通就接着断。半开状态的探测请求数一定要控制,别一下放100个请求过去,那下游刚缓过来又被打挂。

麻烦在于,很多团队根本没有做过全链路压测,所有参数都是拍脑袋定的。限流阈值是多少?看隔壁项目组配的500,我也配500。熔断多久?文档写的30秒,我就抄30秒。上线之后出问题,又把参数改得特别保守,限流设成50QPS,熔断设成100%错误率才触发,等于这俩功能完全成了摆设。
配置上线前要留好动态调整的口子
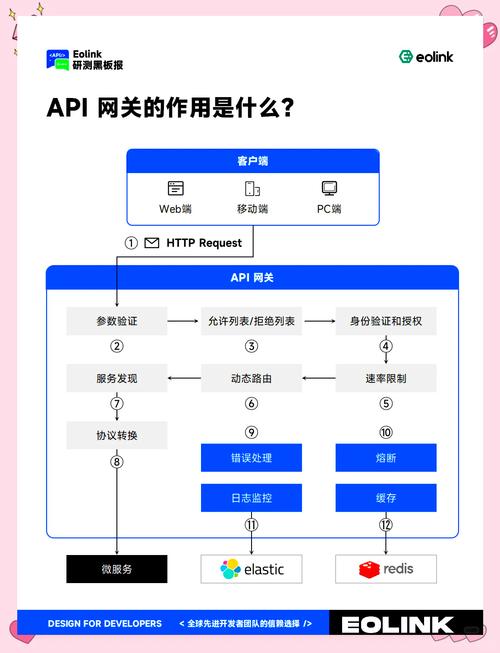
我碰到过最离谱的操作,是把限流和熔断的参数直接硬编码在网关配置文件里,每次改参数要重新发版。大促当天流量涨了30%,要临时调限流阈值,等走完全部发版流程,大促高峰都过去了。
说白了,API网关限流与熔断配置从来不是一劳永逸的静态参数。你得把这些配置放到配置中心里,支持动态推送,甚至可以按不同的接口、不同的用户等级设不同的规则。比如内部运营查询接口,你可以把限流设得高一点,面向普通用户的商品详情接口,就严格按下游的承载能力设阈值。
不过话说回来,也不是说配得越细越好。你要是给每个接口都单独写一套规则,最后维护的人都记不住哪个接口配了啥,反而容易出问题。
之前有个团队,一开始所有接口都走统一的全局限流,后来发现核心下单接口的流量被其他非核心的报表接口占了,就给下单接口单独开了更高的限流优先级,报表接口的流量被限制在10%以内,大促的时候再也没出现过核心链路被非核心请求挤爆的情况。
很多人喜欢吹什么自适应限流,说系统能自动根据负载调阈值。说实话,大部分中小团队的服务规模,根本用不上那套。你把基础的规则配对,留好动态调整的入口,比什么花里胡哨的自适应功能靠谱多了。
上次跟那个零售的后端聊完,他回去把全局限流拆成了每个服务的独立阈值,又把熔断的半开探测数从10个降到1个,上个月大促,整个网关只触发了两次短暂的熔断,每次10秒就恢复了,再也没出现过之前那种全挂的情况。