分布式缓存一致性保障 没人愿意明说的取舍账
上周跟一个做电商中台的朋友吃饭,他吐槽刚被凌晨三点的告警揪起来——用户付了钱才发现库存为0,查了半天才定位到,缓存和数据库的同步差了两秒。就这点事,整个团队折腾到天快亮才把数据对齐。
这事我见过太多次了。
别上来就追强一致 你付不起那个成本
很多人刚接触分布式缓存一致性保障的时候,第一反应是要让缓存和数据库永远分毫不差,差一毫秒都算事故。
说白了,这就是没在生产环境踩过坑的理想主义。你要真上了全链路强一致,所有写操作必须等数据库提交、缓存更新、所有副本同步完成才给前端返回,那接口RT直接涨3倍都算少的,高峰期的QPS砍半都是常态。
真的贵。
真的,别拿通用方案套所有场景。商品详情的价格晚个三秒更新,用户大不了退出去重进,没人会揪着这点差池投诉。但库存数不行,差两秒就会超卖,真金白银的损失没人扛得住。
我见过太多团队上来就把延迟双删当万能解药,结果用在高并发写的库存场景上照样出问题——你删完缓存之后,刚好有个读请求把旧的库存值从数据库捞出来写回了缓存,第二次删的时间要是卡不准,等于前面的操作全白做。
那些被吹成神的方案 都藏着看不见的代价
现在行业里吹得最多的两个方案,一个是写库后发MQ异步更缓存,一个是订阅数据库binlog异步刷缓存。前者听起来解耦,后者听起来对业务无侵入,都是架构图上的完美选项。
但麻烦从来不在架构图上。用MQ的方案,你得处理消息丢了怎么办、消费失败重试会不会造成重复更新、消息积压了缓存滞后多久能追上。之前见过一个团队为了省事,用了没开持久化的普通队列,一次Broker重启直接丢了上千条商品更新消息,缓存里存的全是一周前的旧数据,整整一下午人工刷了上千个key才把数据对齐。
亏不亏?
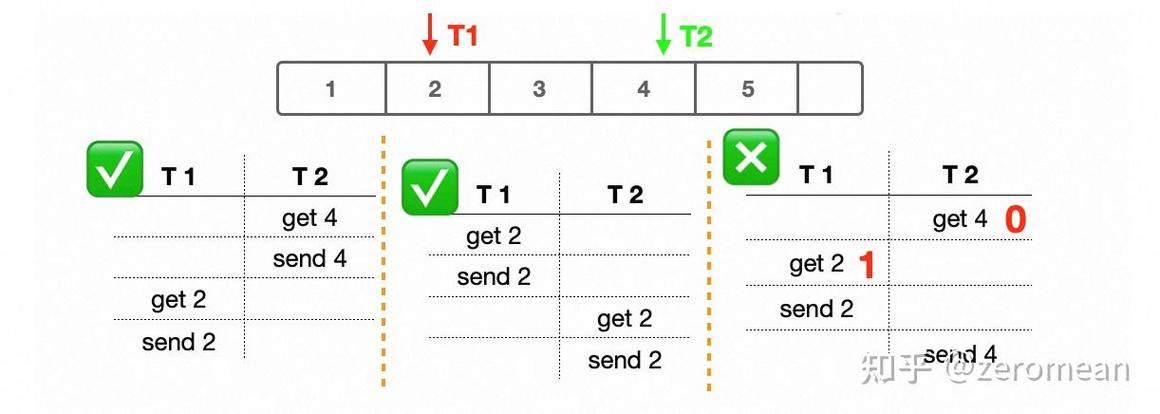
至于binlog订阅的方案,问题也不少。分库分表场景下,同一个商品的更新可能落到不同的分片,binlog的消费顺序根本没法严格保证。刚好两个更新同一个商品的binlog,新值先到被消费了,旧值后到又被写进缓存,最后存的旧数据,比不更新还坑。
很多人介绍这些方案的时候,只会说“高性能、解耦、无侵入”,半字不提你要自己搭幂等校验、顺序保证、死信队列、异常告警这一整套配套机制。说白了,你省的那点业务代码的工作量,最后全得补到日常运维和故障排查上。
别追求完美 留好兜底口子比啥都强
分布式缓存一致性保障这事,从来没有100%的完美解。网络闪断、节点宕机、消息积压这些破事,你就算把所有时序逻辑写得再严谨,也防不住意料之外的异常。
真没必要死磕零差异。给关键的缓存key设个合理的短过期时间,就是最朴素也最有效的兜底。要是同步逻辑真出了问题,最多等过期时间到了,缓存自动从数据库拉最新值,不会一直拿着旧数据坑用户。
我见过最离谱的一个配置,给活动商品的价格缓存设了24小时的过期时间,结果同步逻辑出bug,整整一天页面上挂的都是上个月的大促价格,等运营发现的时候,已经亏了快十万。你说这亏吃的冤不冤?
再就是关键的读接口,别完全信缓存。比如库存的查询接口,只要加个简单的判断:如果缓存里的更新时间和当前时间差超过了10秒,就直接回源查一次数据库,顺便把缓存刷成最新值。几十行代码的事,能挡掉80%的线上一致性事故。
上次和那个踩了库存坑的朋友聊,他现在已经不纠结要做什么架构上的完美方案了。库存缓存的过期时间设成10秒,同步用最朴素的延迟双删,再加了个每分钟跑一次的轻量校验任务,把缓存和数据库差值超过1%的key单独捞出来手动刷新。就这么个没什么技术含量的组合,大半年了没再出过超卖的问题。
技术这事,从来不是越复杂越好。能扛住线上的各种意料之外的破事,比架构图上画得再完美的设计都管用。