Kubernetes多集群管理实践踩坑落地手记
上周跟杭州某电商的运维组喝酒,对方喝到第三杯直接把杯子往桌上一墩——他们三个K8s集群,跨三个可用区,每次发版要登三个控制台输三遍镜像地址,错一个字符就整组回滚,全组熬了两个大夜。
太痛了。
先搞清楚你到底需不需要多集群
说实话,我见过太多团队跟风上多集群,纯粹是看别人都搞,自己不搞显得技术落伍。
单集群其实能扛到几千个工作节点,只要你的网络带宽没瓶颈,单集群跑百万级的Pod都不是问题。什么场景才真的需要拆多集群?要么是有跨地域容灾的硬需求,比如核心业务要在两个相隔上千公里的地域各放一套集群,断网的时候能快速切流;要么是业务线的强隔离要求,比如支付核心链路和普通的营销活动集群,必须物理分开,万一营销活动被打挂了,不能影响支付链路;要么是环境的硬隔离,比如生产、预发、测试环境绝对不能共用一套集群,避免误操作把生产环境搞崩。
别瞎折腾。
踩了三年才摸透的落地细节
最早我们2021年搞多集群的时候,上来就部署了开源的联邦组件,折腾了两周,同步个Namespace要等三分钟,跨集群调度还经常把Pod调度到网络延迟两百毫秒的跨地域节点上,业务方直接找上门骂。
现在想起来都头疼。
后来我们把联邦组件全删了,摸出来一套完全适配自己业务的流程。第一步永远不是搞什么统一管控面板,先把所有集群的运维基线完全对齐——每个集群的kubelet版本、CNI插件版本、RBAC权限规则、镜像仓库的拉取凭证、节点的OS镜像版本,必须完全一致。我们之前就因为预发集群的CNI插件版本比生产低一个小版本,导致同一个NetworkPolicy在生产直接失效,两个测试环境的Pod居然能跨网段互相访问,差点把预发的支付测试数据漏到测试环境。
吓出一身冷汗。
基线对齐之后,再根据团队规模选统一管理的工具。小团队(集群数少于3个)根本不需要什么复杂平台,把kubectl的context配置好,写个简单的切换脚本就够用;中等规模团队(3到10个集群),直接用ArgoCD做GitOps的多集群应用同步就行,不用搞什么花里胡哨的跨集群调度;超过10个集群的大规模团队,再考虑引入统一的管控面板做资源配额的全局管控。
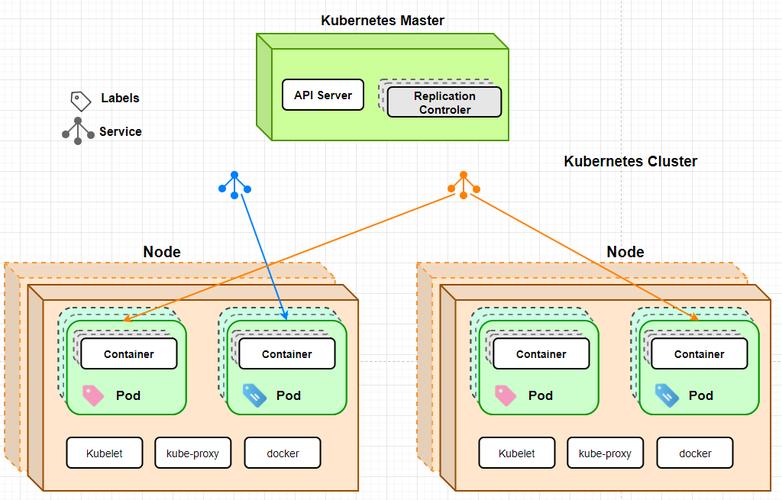
官方文档不会写的隐形坑
别信那些吹什么统一管控面板能解决所有问题的鬼话。
我们现在的方案里,从来不会把所有集群的运维权限都收到一个中央面板里——万一中央面板出个配置错误,或者被人攻破,所有集群直接全挂,这锅谁背?每个集群的独立运维入口我们都保留,中央面板只做应用部署的同步和资源的全局监控,绝对不做直接的集群操作权限。
还有跨集群的服务发现,别上来就折腾什么全链路服务网格。小团队直接用外部DNS把每个集群的核心服务暴露出去,比折腾Istio的跨集群流量路由简单十倍。我们之前试过为了跨集群的服务调用,把三个集群全接入Istio,光调通流量路由就花了一个月,最后因为网格的overhead太高,服务调用延迟涨了30%,又全拆了。
还有多集群的监控告警,别把所有集群的指标都堆到一个Prometheus实例里。我们之前就是这么干的,每个集群存三个月的指标,三个集群直接把监控服务器的磁盘吃满了,告警停了两天,线上出了个节点磁盘满的问题,过了四个小时才被用户反馈发现。
丢死人。
不过话说回来,多集群管理从来没有什么银弹。你要是团队连单集群的运维都还没摸明白,连节点镜像的自动升级都做不到,就别凑多集群的热闹。上个月有个创业公司的技术负责人找我聊,说他们10人不到的技术团队,要搞四个多集群,分别对应四个不同的业务线,我直接劝他把三个小集群合并了——省下来的时间多给产品加两个功能,不比天天排多集群的网络问题香?
上周跟那个杭州电商的运维组聊完,给他们出了个初步方案:先把三个集群的基线对齐,用ArgoCD做统一的发版流程,暂时不搞复杂的跨集群调度,先把发版要登三个控制台的问题解决。昨天他给我发消息,说第一次全组发版只用了20分钟,以前要折腾两个小时。
哦对,忘了说。
别为了技术而技术。
能把日常发版的效率提上去,就是最好的实践。