性能压测场景设计与数据构造实战避坑手记
去年帮华东一家做家居电商的团队做618前的容量评估,现在想起来那个技术负责人在大促现场拍大腿的样子,我都觉得脑壳疼。
他们提前三周就启动了压测,跑出来的报告漂亮得不行:1500并发下核心接口平均RT180ms,错误率0.02%,所有指标全绿。结果大促当天前15分钟,支付接口直接崩了,502报错刷了三屏监控。
为啥?
问题出在他们的场景设计上。整个压测脚本写得规规整整,所有虚拟用户的路径完全一致:打开首页、搜关键词、进商品详情、加购物车、点结算、提交支付。循环跑了几十轮,流量曲线平滑得像小学生画的直线。
可真实的用户哪是这么走的?
那天的流量里,至少4成是提前蹲点抢满减券的精准用户,进来直接点领券链接,抢完立刻跳支付页,根本不逛首页、不搜商品、不对比参数。压测的时候完全没把这个路径算进去,等于所有压测的流量都绕开了支付接口的高并发峰值,看起来负载很轻,真等真实流量一冲,连接池瞬间就被打满。
电商大促用户真实访问路径热力图
很多团队做场景设计的时候,总喜欢拿“理想用户”当模板,把所有链路的流量比例拆得整整齐齐,却忘了真实世界里的用户行为是歪歪扭扭的。有人进来就走捷径,有人在支付页犹豫半小时才提交,有人反复刷新商品详情页看评价,这些零散的、不按套路走的请求,才是最容易把系统搞崩的变量。
比场景错了更让人崩溃的,是压测用的数据根本和线上对不上。
我见过最离谱的造数据操作,是某SaaS团队为了压测组织架构接口,批量插了200万条组织节点,所有节点的层级完全一样,所有员工的部门归属全是平均分配。压测跑了一小时,接口性能好得能飞,结果上线之后,真实用户的组织架构是金字塔形的,最顶层的根节点每次查询都要遍历全量子节点,RT直接飙到3秒。
还有的团队造数据的时候,把所有测试用户的密码都设成123456,压测跑了俩小时才发现,登录接口的缓存命中率比真实场景高了30%——因为重复的密码值根本没触发缓存的淘汰逻辑,等于压测的负载比真实情况轻了一大截。
说白了,你造的数据要是和线上的分布差得远,那压测测的根本不是你的生产系统,是你在测试环境里搭的个玩具模型。所有好看的指标,都是自欺欺人。
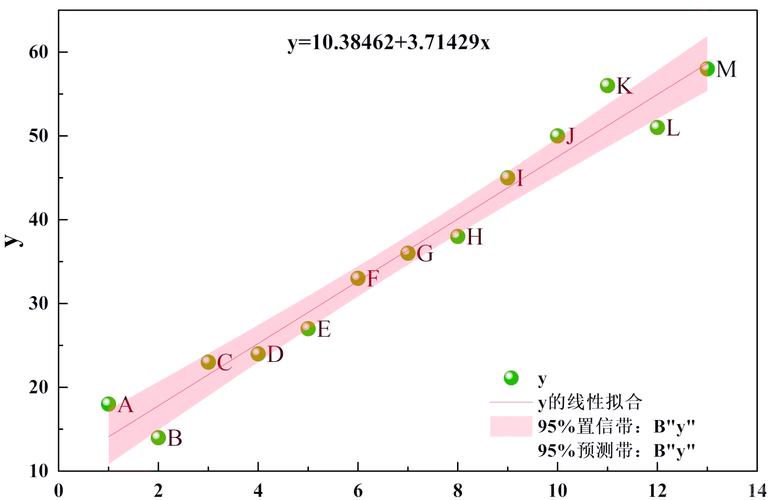
压测数据分布与线上真实数据对比散点图
上次帮那个家居电商团队调整压测方案的时候,我们没急着改脚本,先拉了最近3个月的线上访问日志,按用户ID聚合出真实的路径占比:领券链路占28%,商品详情页占22%,支付提交占18%,剩下的才是首页浏览、搜索、加购这些零散路径。
我们也没只压单链路的峰值,专门加了个“流量叠加尖峰”的场景:领券的流量峰值和支付提交的流量峰值,完全叠在同一个10秒的窗口里。脚本刚跑了30秒,监控上的支付接口RT就从200ms飙到800ms,顺藤摸瓜查下去,才发现库存扣减的逻辑用了行锁,爆品SKU的那行数据,在高并发下被反复争抢,直接把整个接口拖慢了。
数据构造这边我们也没搞批量生成那套,直接把上个月的线上业务数据脱敏之后同步到压测环境——手机号全换成随机的虚拟号,地址全换成测试地址,但是数据的分布、字段长度、关联关系完全和线上保持一致。我们还特意留了当时的爆品SKU在压测库里,模拟真实场景下的热点行访问。
调整完之后再跑压测,之前藏得很深的问题全被揪了出来。大促当天,支付接口的峰值流量比我们压的阈值还高20%,系统稳得一批,那个技术负责人后来请我喝了三瓶冰可乐。
说真的,压测这事儿真没什么捷径。你要是偷懒不想翻日志,不想核对数据分布,光靠个网上抄来的脚本跑个1000并发就拍胸脯说系统稳了,早晚要在生产环境栽跟头。
他们提前三周就启动了压测,跑出来的报告漂亮得不行:1500并发下核心接口平均RT180ms,错误率0.02%,所有指标全绿。结果大促当天前15分钟,支付接口直接崩了,502报错刷了三屏监控。
为啥?
别拿压测报告当通关文牒
问题出在他们的场景设计上。整个压测脚本写得规规整整,所有虚拟用户的路径完全一致:打开首页、搜关键词、进商品详情、加购物车、点结算、提交支付。循环跑了几十轮,流量曲线平滑得像小学生画的直线。
可真实的用户哪是这么走的?
那天的流量里,至少4成是提前蹲点抢满减券的精准用户,进来直接点领券链接,抢完立刻跳支付页,根本不逛首页、不搜商品、不对比参数。压测的时候完全没把这个路径算进去,等于所有压测的流量都绕开了支付接口的高并发峰值,看起来负载很轻,真等真实流量一冲,连接池瞬间就被打满。
很多团队做场景设计的时候,总喜欢拿“理想用户”当模板,把所有链路的流量比例拆得整整齐齐,却忘了真实世界里的用户行为是歪歪扭扭的。有人进来就走捷径,有人在支付页犹豫半小时才提交,有人反复刷新商品详情页看评价,这些零散的、不按套路走的请求,才是最容易把系统搞崩的变量。
数据造不对,压测等于白干
比场景错了更让人崩溃的,是压测用的数据根本和线上对不上。
我见过最离谱的造数据操作,是某SaaS团队为了压测组织架构接口,批量插了200万条组织节点,所有节点的层级完全一样,所有员工的部门归属全是平均分配。压测跑了一小时,接口性能好得能飞,结果上线之后,真实用户的组织架构是金字塔形的,最顶层的根节点每次查询都要遍历全量子节点,RT直接飙到3秒。
还有的团队造数据的时候,把所有测试用户的密码都设成123456,压测跑了俩小时才发现,登录接口的缓存命中率比真实场景高了30%——因为重复的密码值根本没触发缓存的淘汰逻辑,等于压测的负载比真实情况轻了一大截。
说白了,你造的数据要是和线上的分布差得远,那压测测的根本不是你的生产系统,是你在测试环境里搭的个玩具模型。所有好看的指标,都是自欺欺人。
踩过坑才摸出来的落地细节
上次帮那个家居电商团队调整压测方案的时候,我们没急着改脚本,先拉了最近3个月的线上访问日志,按用户ID聚合出真实的路径占比:领券链路占28%,商品详情页占22%,支付提交占18%,剩下的才是首页浏览、搜索、加购这些零散路径。
我们也没只压单链路的峰值,专门加了个“流量叠加尖峰”的场景:领券的流量峰值和支付提交的流量峰值,完全叠在同一个10秒的窗口里。脚本刚跑了30秒,监控上的支付接口RT就从200ms飙到800ms,顺藤摸瓜查下去,才发现库存扣减的逻辑用了行锁,爆品SKU的那行数据,在高并发下被反复争抢,直接把整个接口拖慢了。
数据构造这边我们也没搞批量生成那套,直接把上个月的线上业务数据脱敏之后同步到压测环境——手机号全换成随机的虚拟号,地址全换成测试地址,但是数据的分布、字段长度、关联关系完全和线上保持一致。我们还特意留了当时的爆品SKU在压测库里,模拟真实场景下的热点行访问。
调整完之后再跑压测,之前藏得很深的问题全被揪了出来。大促当天,支付接口的峰值流量比我们压的阈值还高20%,系统稳得一批,那个技术负责人后来请我喝了三瓶冰可乐。
说真的,压测这事儿真没什么捷径。你要是偷懒不想翻日志,不想核对数据分布,光靠个网上抄来的脚本跑个1000并发就拍胸脯说系统稳了,早晚要在生产环境栽跟头。