上次跟认识快十年的后端老同事吃夜宵,他刚从公司线上告警里抽出身,灌了半瓶冰可乐才缓过来。
啥问题?
慢查询。
排查了快四十分钟,发现核心订单表的一个常用查询字段,忘了加索引。全表扫了近两千万行,差点把从库的连接占满,连带两个下游服务超时。
很多人刚接触数据库的时候,总觉得慢查询是因为服务器配置不够好,加更多内存换更快的SSD就能解决,从来没想过可能只是少了一个几十KB的索引。
你以为的全表扫描,到底有多慢
你翻过一本没有目录的新华字典吗?
要找一个不认识的字,不知道拼音也不知道部首,只能从第一页逐页翻到最后一页,找到的时候胳膊都酸了。数据库全表扫描,就是这个状态。
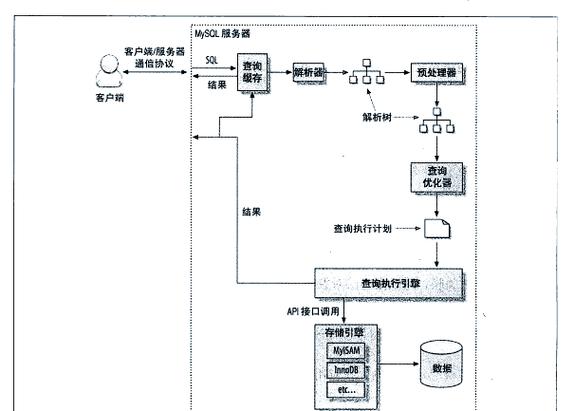
没有索引的表,所有数据行是按照写入顺序存在磁盘页里的,没有任何顺序可言。要找某一行符合条件的数据,就得从第一个磁盘页开始,逐页读进内存,逐行比对条件,直到把所有数据都扫完。数据量小的时候,比如几千行,你根本感觉不到差别。真到了几百万、几千万行的量级,一次全表扫描可能要读几十上百MB的磁盘数据,耗时从毫秒级飙到秒级,甚至分钟级。
数据库索引的本质,是把原本无序的磁盘存储行,提前按照特定字段的顺序排好,建一套可以快速定位的映射结构。就像字典前面的拼音检索表、部首检索表,你不用逐页翻,直接通过目录定位到对应的页码,一步就能找到要找的内容。
这事没那么玄。
不是什么高深的计算机理论,就是把“提前排好序”的思路用到了磁盘存储上,把原本随机的磁盘IO,变成了可以快速定位的顺序查找。
加了索引,不代表你就赚了
见过太多开发,把索引当万能药。
但凡有个慢查询,第一反应就是给查询条件里的所有字段都加上索引,觉得这样就能快。
错。
索引是有成本的。
你每往表里写一行数据,数据库不光要把整行数据写到对应的磁盘数据页里,还要同步更新所有关联的索引页。写操作的耗时,会随着索引数量的增加线性上涨。
之前接触过一个团队,核心用户行为表加了17个索引,覆盖了所有能想到的查询字段。结果高峰期写入延迟直接飙到800ms,业务侧上报的埋点丢失率快到15%。后来DBA拉着开发团队把没用的索引全删了,只留了3个真正高频查询用到的,写入延迟直接掉回20ms以内,查询性能一点没降。
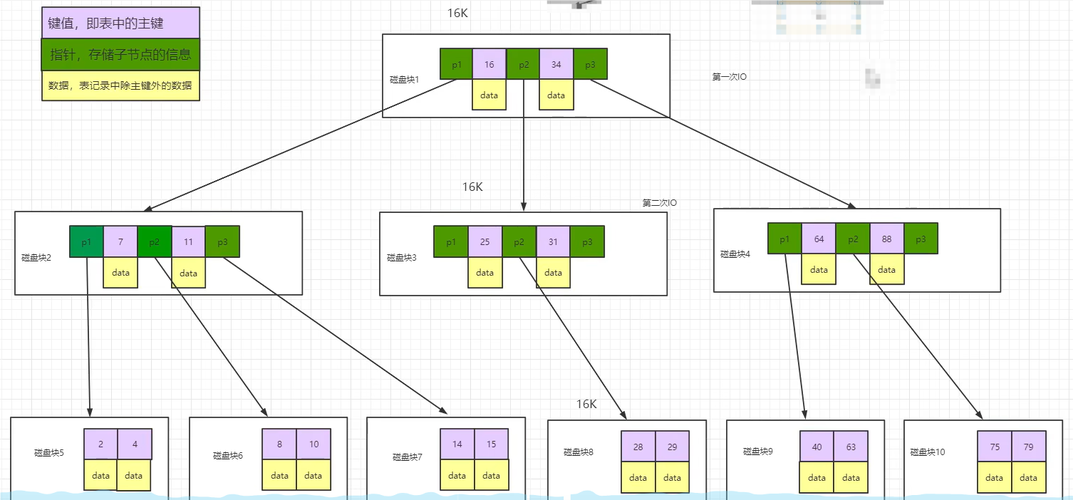
现在主流关系型数据库用的B+树索引,已经是综合了读写性能、磁盘IO成本的最优解了。树的高度通常只有三四层,就能存下几千万甚至上亿行的数据,一次查询最多只需要读三四次磁盘页,比全表扫描的成本低几个数量级。
但麻烦在于,你建的联合索引,字段顺序错了,等于白建。
比如你建了(用户ID,下单时间)的联合索引,结果写SQL的时候,先按下单时间过滤,再匹配用户ID,数据库根本用不上这个索引。白攒了。
踩过这个坑的人,举个手。
那些没人会主动告诉你的坑
别以为建完索引就万事大吉,这里面的坑,能把刚入行的开发坑到怀疑人生。
最常见的,就是在索引字段上套函数。比如写where date(create_time) = ‘2024-01-01’,你以为数据库能聪明到自动用上create_time的索引?想多了。数据库得把每一行的create_time字段拿出来,套上date函数算一遍结果,再跟条件比对,索引直接失效,退化成全表扫描。
正确的写法很简单,把范围条件挪到函数外面,直接用create_time between 两个时间点的写法,就能正常走索引。
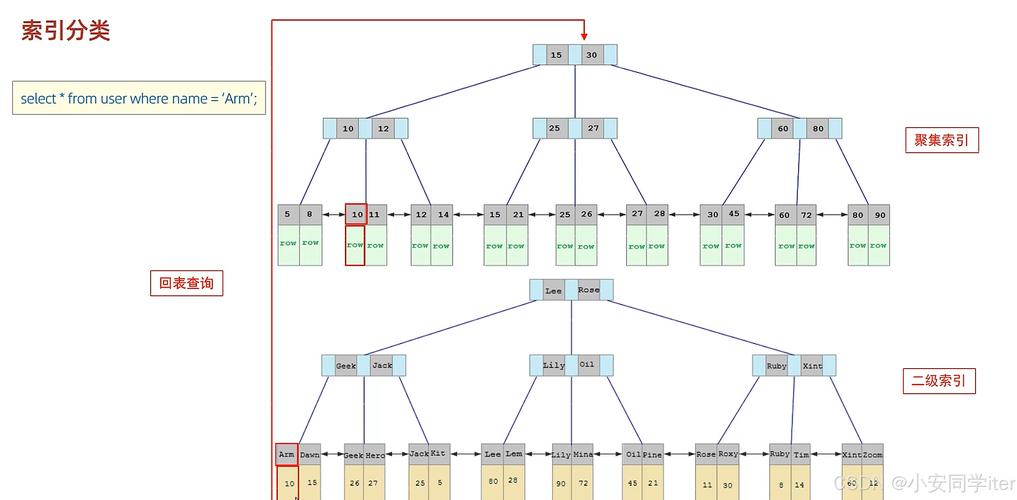
还有的坑,藏在执行计划的假象里。你明明看到SQL走了索引,结果查了半天还是慢——因为查的字段根本不在索引的覆盖范围内,查完索引定位到行的位置,还得回表去原始数据页拿整行数据。
回表操作的成本,往往比你想象的高得多。如果回表的次数太多,优化器算下来,还不如直接全表扫描划算。
还有个很容易被忽略的点,就是索引的区分度。比如你在性别字段、订单状态这种只有几个固定值的字段上建索引,全表一半的数据都符合某个值,查一次就要扫一半的数据。优化器算来算去,觉得走索引的成本比全表扫描还高,干脆直接放弃用你建的索引,白占了磁盘空间。
之前跟一个做了十年的DBA聊天,他说最头疼的就是开发提交的索引变更申请。上来就说“这张表慢查询多,麻烦加个索引”,问他具体是哪个查询场景,用哪个字段过滤,区分度多少,他啥也说不出来,就是拍脑袋要加。
真的,数据库索引从来不是免费的午餐。
你要算清楚自己的表是读多还是写多,哪些字段是真的会被高频用来做过滤,哪些字段只是偶尔查一次。别一上来就把所有字段都建上索引,跟你出门带一整箱工具,真要拧个螺丝的时候,反而在箱子里翻半天找不到扳手。
上次那个被慢查询搞到夜宵都吃不安生的老同事,后来把那张订单表的索引从8个删到剩2个,写入性能涨了40%,核心查询的耗时一点没涨。
就这么简单。