凌晨两点四十,值班群里弹出一行字。新版本在灰度池活了不到一小时,网关开始丢连接。
没人喊,也没人甩锅。那一刻最要紧的事只有一件,回滚。可回滚按钮按下去之后,往往才是麻烦的开头。
别背定义了 先说它到底在赌什么
灰度发布这东西被说得太玄。说白了,就是在全量之前,把新代码交给一小部分真实流量去蹂躏,看它扛不扛得住。
听起来温和。但它本质是一场有边界的赌博。你赌的是,这三五个点的流量,能替你暴露八成的问题。
赌注的边界怎么划?三个维度,缺一个都不完整。
流量维度。按用户 ID 取模、按设备号、按地域、按白名单,哪种都行。关键是要能被复现——同一个用户今天分到新版本,明天还得是新版本。不然用户会看到两套界面来回切,客服电话能被打爆。
部署维度。金丝雀实例、服务网格的流量切分、网关路由。这一层现在工具很成熟了,写几行配置就能给一组实例挂上不同权重。
数据维度。这才是最容易被忽略、又最容易出人命的。新版本改了表结构?缓存 key 变了?消息格式跟老消费者对不上?

前两个维度,工程平台基本都替你解决了。第三个没有平台能替。它必须由写代码的人自己扛。
分流规则好写 难的是让一个人始终待在同一个版本里
有个团队做过推荐策略的灰度。目标很朴素,先在某个城市推给一部分用户,观察点击率的波动。
规则配完,上线,看起来挺顺。第二天客诉来了,说优惠券能重复领。
排查下去,原因不复杂。用户的推荐流走了新版本,但购物车结算还在老版本,两边的优惠计算逻辑对不上。灰度是按接口切的,不是按用户体验切的。
这就是最常见的坑:你切的是流量,用户感受到的是一个完整的链路。
麻烦在于,现代系统的调用链深得吓人。一个下单请求可能穿过网关、用户服务、商品服务、营销服务、风控、支付。你把其中三个切到新版本,两个留在旧的,中间的数据契约就得靠人一个一个去兜。
所以做灰度之前,先画一张图。这次改动会碰到哪些服务,这些服务之间的接口有没有变化。有变化的地方,就是必须一起灰度的地方。哪怕它跟你的需求看起来八竿子打不着。
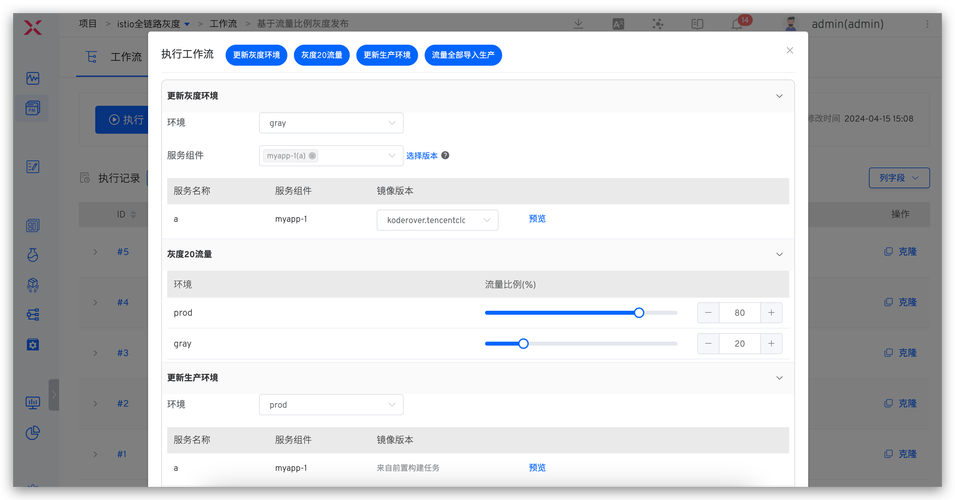
还有个细节,会话粘滞。老系统里靠 cookie 或者客户端 IP 做粘滞,一到移动端、一到多出口网关,这套就不灵了。用统一的分流标识,比如从用户 ID 派生出来的一个稳定值,比什么都稳。
回滚按下去之后 才是真正的考试

很多人以为回滚就是代码回退一下,再重新部署。
要是这么简单,就没有那么多事故了。
数据库加了字段,新版本写进去一堆数据,老版本根本不认识这些字段。你回滚了代码,数据留在那儿,成了定时炸弹。或者更糟,老代码读到半截数据,直接抛异常,写请求全堵住。
这类问题的解法不新鲜,但确实要做。
先加字段,不动老字段。老代码忽略新字段,新代码双写一段时间。等全量稳定了,再删老字段。这套流程拖慢上线节奏,产品经理会问,为什么一个小需求要分三次发布?你只能解释,因为这是唯一能让回滚真的可用的办法。
代价是要付的。要么在上线前付,要么在凌晨两点半付。
还有一个经常被忽视的点,回滚演练。绝大多数团队的灰度流程里,回滚是写在文档里的,从来没真跑过。真出事的时候,运维发现回滚脚本依赖的那个配置中心权限,三个月前就被收走了。这种坑,你不演练永远发现不了。
指标定在放量之前 不然就是拍脑袋

放量节奏怎么走,一个点、五个点、两成、一半、全量?
数字本身不重要。重要的是,每一步停下来的时候,看什么。
技术指标得提前定。错误率、P99 延迟、CPU、GC、下游依赖的调用量。业务指标也得定。下单转化、支付成功率、次日留存、客诉量。两边都要有人盯。
最怕的情形是,灰度放了两天,业务方说转化好像跌了,技术方说监控一切正常。然后大家对着两个完全不同口径的数字吵到天亮。口径要在上线前对齐,谁负责看哪几个数,跌到什么程度触发回滚,回滚谁说了算。这些事写在纸上比写在脑子里靠谱。
不过话说回来,指标再全,也替代不了人的判断。有些问题就是数字看不出来的,按钮位置别扭,配色难看,这些只能靠人去看、去问。这活儿累,但省不掉。
最后落在哪儿
灰度发布这东西,工具层面早就不是什么难题了。真正难的是纪律。
一个团队愿不愿意在每次上线前多花两小时做兼容性评估,愿不愿意把回滚当真跑一遍,愿不愿意为了一个用户标识的稳定性去改老代码。这些跟技术无关,跟习惯有关。
新版本上线那天顺不顺利,其实在写第一行代码的时候就已经决定了大半。
下次上线之前,别急着切流量。先问一句,如果现在必须回滚,我们二十分钟内能不能干净地退回去?
答案如果是「应该可以」,那就等于不能。