实时计算任务的资源调优,很多时候不是从 YAML 开始的。是从一条告警开始的。凌晨两点,消费延迟曲线抬头。你打开监控,看到反压。然后手一抖,把并行度从 8 改成 32。重启。发现延迟更高了。这事我见过不止一次。
所以先别急着加资源。先问三个问题:瓶颈在哪,代价是什么,业务能不能接受。听起来像废话。但现场大部分人跳过这三步,直接进到调参玄学。

反压不是敌人 它是你唯一靠谱的线人
实时计算任务最怕什么?不是数据量大。是数据量大的时候,你不知道哪一段在拖后腿。Flink 的反压指标、Spark Streaming 的批次处理时间、Kafka 的消费 lag,这些都不是让你焦虑的。是让你定位的。
反压出现,通常意味着下游处理能力不足。可能是算子逻辑重,可能是外部存储慢,可能是数据倾斜。你要做的不是把并行度调大,而是找到那一个或几个 subtask。看 busy 时间,看 backpressure 等级,看 checkpoint 对齐时间。如果某个 subtask 的 busy 一直 90% 以上,其他 subtask 闲得发慌,那基本就是倾斜。加并行度只会让更多 subtask 闲着。
我采访过一个做风控实时特征计算的团队。他们的任务从 Kafka 读数据,做窗口聚合,写 HBase。白天还好,晚上流量峰值一来,延迟从 200 毫秒飙到 5 秒。一开始他们加内存,加 CPU,把 TaskManager 从 4 个扩到 12 个。没用。后来发现是 HBase 的 rowkey 设计有问题,热点集中在几个分区。改了 rowkey 之后,资源没变,延迟回到 300 毫秒以内。这个案例不新鲜。但每次都有人踩。
所以反压不是让你立刻扩资源的信号。它是让你去看代码和数据的信号。先定位,再调参。顺序错了,钱白花。
并行度和槽位 不是许愿池
并行度怎么设?常见回答是:跟 Kafka 分区数对齐。对,但不全对。如果任务里有 keyBy,并行度还要考虑 key 的分布。如果 key 特别集中,并行度再高也没用。如果任务里有 window,窗口大小和滑动步长也会影响状态大小。状态大了,checkpoint 就慢。checkpoint 慢,反压更容易出现。这是个循环。
槽位呢?一个 TaskManager 上放几个 slot,取决于内存和 CPU。不是越多越好。slot 多了,JVM 堆内存被分摊,每个 slot 能用的内存变少。频繁 GC 就来了。GC 一停,整个 TaskManager 上的任务都受影响。你以为是网络抖动,其实是内存不够。
我一般会建议:先把单个并行度的处理能力压出来。用监控看每条数据的处理耗时,看 CPU 使用率,看 GC 时间。如果 CPU 没跑满,GC 也不高,但延迟就是下不去,那可能是外部系统慢,或者锁竞争。这时候加并行度,等于往一个堵住的下水道里倒更多水。

还有内存。实时计算任务的内存分三块:堆内存、堆外内存、网络缓冲。Flink 里还有 managed memory。很多人只调堆内存,忽略了网络缓冲。网络缓冲不够,上游发不出去,下游收不进来,反压照样出现。托管内存如果给得太大,堆内存就小,容易 OOM。给得太小,RocksDB 状态后端又不够用,读写磁盘频繁,延迟上升。这个平衡点因任务而异。没有通用公式。
说实话,资源调优最烦的就是没有通用公式。你在这个任务上试出来的参数,换一个任务可能直接崩。所以别抄作业。要看监控,做实验,一次只改一个变量。改完观察至少一个完整业务周期。别在高峰期改。别一次改五个参数。不然你不知道是哪个起了作用,哪个埋了雷。
状态后端与 checkpoint 的暗中较劲
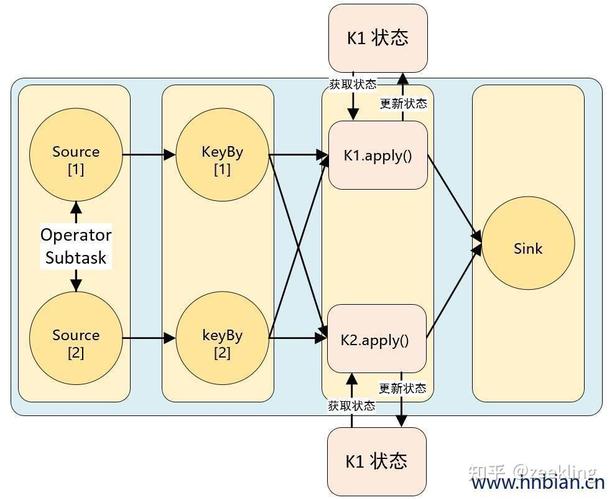
实时计算任务有没有状态,决定了资源调优的难度。无状态任务简单,扩并行度基本能线性提升。有状态任务麻烦。状态越大,checkpoint 越慢,恢复时间越长。恢复时间长,业务中断时间就长。这代价很多时候比多花点资源更贵。
选状态后端,RocksDB 适合大状态,但读写有序列化开销。HashMap 适合小状态,快,但受限于内存。如果状态不大,别上 RocksDB。如果状态很大,又要求低延迟,那就得看增量 checkpoint。增量 checkpoint 可以减少每次上传的数据量,但依赖 RocksDB 的 SST 文件。文件合并策略没调好,反而可能更慢。
Checkpoint 间隔怎么设?太短,频繁触发,影响吞吐。太长,恢复时数据重放多,延迟高。一般建议先看端到端延迟要求。如果要求秒级,checkpoint 间隔可以设几十秒。如果要求亚秒级,得考虑更轻量的状态管理,或者把状态外移到外部存储。但外移又会增加网络调用。又是取舍。
还有 checkpoint 超时。默认 10 分钟,很多任务跑不到。超时原因可能是状态太大,可能是网络带宽不够,可能是 HDFS 写入慢。有一次一个任务,checkpoint 一直超时。大家怀疑是状态太大,准备扩内存。结果查下来是 HDFS 的 DataNode 磁盘满了。资源调优有时候不是调计算资源,是调存储资源。甚至调运维流程。
所以调优之前,先把监控链路打通。没有监控的调优,就是闭眼开车。你不知道前面是弯道还是悬崖。Prometheus、Grafana、Flink Metrics、Spark UI,这些工具得用起来。至少要知道每个算子的吞吐、延迟、反压比例、GC 时间、checkpoint 耗时。这些指标比任何经验都可靠。
资源调优的尽头是业务语义

技术参数调到一定程度,就会碰到业务天花板。比如你有一个去重逻辑,窗口 24 小时,数据量每天几十亿。状态必然大。你再怎么调 RocksDB,读放大和写放大都在。这时候要问业务:真的需要精确去重吗?能不能接受布隆过滤器?能不能把窗口缩短?能不能预聚合?这些问题的答案,比调 JVM 参数更能解决问题。
再比如,实时计算任务的结果要写数据库。如果数据库写入是瓶颈,你调计算资源没用。得看批量写入、异步写入、连接池大小。如果数据库不支持高并发写入,那就得加缓冲层,比如 Kafka 或 Redis。但这又引入新的延迟和一致性问题。没有免费午餐。
我见过一些团队,把实时计算任务当成离线任务调。堆资源,堆并行度,结果成本上去了,延迟没下来。问他们监控,说没细看。问他们业务要求,说越快越好。越快越好就是没有目标。没有目标,调优就没有终点。
所以我的建议是:先把延迟目标定下来。P99 多少?平均多少?能接受多少数据延迟?然后看当前瓶颈在哪。是 CPU,是内存,是网络,是磁盘,还是外部系统。找到瓶颈,针对性地调。调完看效果。如果没效果,回滚,换方向。别恋战。
还有一点,资源调优不是一次性工作。业务量在涨,数据分布在变,代码在迭代。今天调好的参数,下个月可能就不适用了。所以要把调优动作自动化。比如根据 lag 自动扩缩容,根据 CPU 使用率动态调整并行度。这不容易,但比人工救火强。
最后说个反直觉的:有时候资源调优的最好方法是减少资源。把不必要的算子去掉,把重复的计算合并,把状态清掉。代码层面的优化,往往比加机器更有效。但代码优化需要开发介入,需要时间。而加机器只需要点一下按钮。所以很多人选择点按钮。然后账单来了。
实时计算任务的资源调优,说到底是在延迟、吞吐、成本、稳定性之间找平衡。没有银弹。没有万能配置。只有对业务的理解,对监控的信任,和一次次小心翼翼的试验。别信那些一键调优的广告。信你的监控。信你的实验记录。