边缘计算节点运维管理的一线实操细节
上周三在江宁的智能制造产业园。
蹲在机柜后面到凌晨两点。
车间里的通风扇嗡嗡转,凉风吹得后颈发僵。客户的MES系统突然集体卡壳,产线上的传感器数据全断了上传通道,整条组装线停了四十分钟,算下来损失快二十万。
排查到最后才发现,是车间角落放的三个边缘计算节点,因为旁边的焊接设备散热没做好,机柜里的温度飙到了72度,触发了节点的过热保护自动关机。
错了。
真正跑过现场的人都知道,超过六成的边缘节点,根本不在恒温恒湿的核心机房里。它们可能挤在车间的设备夹层里,可能挂在写字楼楼顶的基站支架旁,可能塞在地下停车场的收费机柜里,甚至可能被放在小区物业的杂物间角落。
之前碰到过最离谱的一次,有个部署在社区快递柜旁边的边缘节点,被保洁阿姨当成废弃的旧路由器拔了电源,整整离线了三天,直到快递柜的取件码系统刷不出来,用户打投诉电话打到运营总监那里,运维才反应过来节点出问题了。
智能制造车间角落边缘计算节点部署实拍
这些藏在物理世界里的不确定性,是所有集中式机房运维经验覆盖不到的盲区。你在机房里用了十年的监控规则、告警阈值、自动化脚本,搬到这些环境恶劣的边缘节点上,可能完全失效。比如你给节点设了60度的温度告警,结果车间的焊接工序一启动,机柜温度半小时就冲到70度,告警消息还卡在中心云的传输通道里,等你在工位上收到推送,节点早就触发保护关机了。
说真的,谁没为这种破事赔过加班费啊。
算完账才傻了。
全市分布的230个边缘节点,每个节点每天产生12G的监控和日志数据,按专线带宽的成本算,一年光传输费用就要花18万。更要命的是,只要节点所在的园区出现网络波动,中心云的监控面板上,对应节点的状态直接变成灰色,连个实时的运行数据都收不到,运维坐在指挥中心里,根本不知道现场是断网了,还是节点真的挂了。
后来他们把整个架构反过来改了。
把80%的异常判断逻辑下沉到边缘节点本地。比如节点检测到自身温度超过75度、磁盘占用超过90%、网络连续断连超过10秒的时候,先在本地触发自动清理缓存、降负载、重连网络的动作,只把需要人工介入的关键告警,通过低成本的窄带通道回传到中心平台。全量的日志和监控数据,存在节点本地的存储里,等网络空闲的时候再慢慢同步。
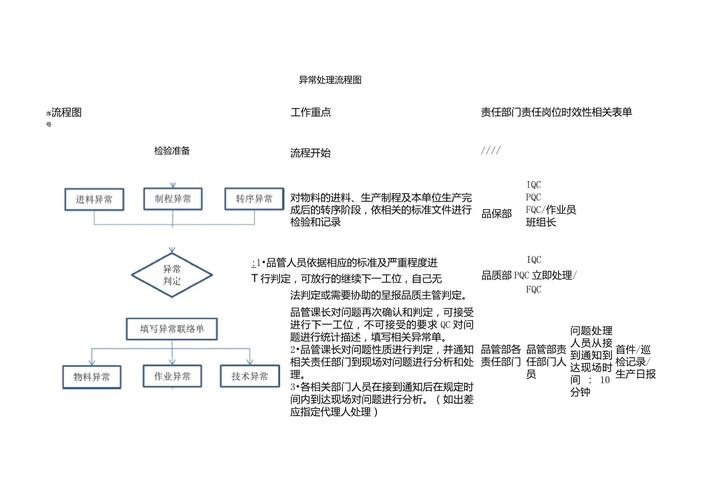
边缘节点本地异常自动处理流程示意图
改完之后,整体的带宽成本直接降了70%,断网的时候中心侧也能收到节点最后一次上报的状态信息,不会对着满屏的灰色状态瞎猜。上次碰到一个园区的运营商基站升级,公网IP整体变更,所有之前配了固定连接的节点,靠着本地的自动重连脚本,两分钟就自动接入了新的网络通道,连运维的告警群都没惊动。
你说这事闹的,要是当初硬抱着全量回传的思路不改,那天说不定又要跑现场爬机柜,麻烦园区保安帮忙按重启键。
真的落地过的团队都知道,一开始就追求大而全的平台,最后大概率会变成没人用的摆设。
南京本地有个做智慧停车的客户,之前管理全市320个公共停车场的边缘节点。最开始找了个厂商搭了一套全功能的边缘运维平台,花了快三个月,把资产盘点、日志分析、自动化巡检、远程配置的功能全做进去了。结果上线才发现,很多老停车场的网络带宽只有2M,连平台要求的agent都装不上,硬装上去之后,节点的CPU占用直接涨了40%,影响了停车场收费系统的正常运行。
我当时陪着他们的运维团队蹲在新街口停车场的机柜旁边拆设备,夏天的蚊子咬了好几个包,就为了测那个agent的CPU占用,现在想想都觉得闷热。
后来他们把平台的功能砍到只剩两个。
第一个是节点离线告警,只要节点连续5分钟没上报心跳,就第一时间给对应区域的运维发消息,别等车主扫不开码、缴费失败了才收到投诉。第二个是基础的远程重启能力,碰到节点假死的情况,不用大老远跑现场,在手机上点一下就能触发重启。
就这两个功能,上线之后,运维的现场出差量直接砍了72%。剩下的出差,基本都是碰到电源被拔、硬盘物理损坏这种真的需要上门处理的情况,跑一趟也认了。
真的,做边缘计算节点运维管理,别端着工程师的架子。
别信那些吹得天花乱坠的概念。
先把最痛的问题解决了——节点挂了能第一时间知道,不用每次跑现场爬机柜。这比什么高大上的技术架构都实在。
路要一步一步走。
现场的坑,总得一个个踩。
蹲在机柜后面到凌晨两点。
车间里的通风扇嗡嗡转,凉风吹得后颈发僵。客户的MES系统突然集体卡壳,产线上的传感器数据全断了上传通道,整条组装线停了四十分钟,算下来损失快二十万。
排查到最后才发现,是车间角落放的三个边缘计算节点,因为旁边的焊接设备散热没做好,机柜里的温度飙到了72度,触发了节点的过热保护自动关机。
藏在物理机柜里的隐性成本
很多人对边缘节点运维的印象,还停留在远程敲敲命令、看看监控面板的层面。错了。
真正跑过现场的人都知道,超过六成的边缘节点,根本不在恒温恒湿的核心机房里。它们可能挤在车间的设备夹层里,可能挂在写字楼楼顶的基站支架旁,可能塞在地下停车场的收费机柜里,甚至可能被放在小区物业的杂物间角落。
之前碰到过最离谱的一次,有个部署在社区快递柜旁边的边缘节点,被保洁阿姨当成废弃的旧路由器拔了电源,整整离线了三天,直到快递柜的取件码系统刷不出来,用户打投诉电话打到运营总监那里,运维才反应过来节点出问题了。
这些藏在物理世界里的不确定性,是所有集中式机房运维经验覆盖不到的盲区。你在机房里用了十年的监控规则、告警阈值、自动化脚本,搬到这些环境恶劣的边缘节点上,可能完全失效。比如你给节点设了60度的温度告警,结果车间的焊接工序一启动,机柜温度半小时就冲到70度,告警消息还卡在中心云的传输通道里,等你在工位上收到推送,节点早就触发保护关机了。
说真的,谁没为这种破事赔过加班费啊。
别把集中式运维的思路硬套到边缘侧
有个做工业互联网的老客户,前两年刚上了全套的云边协同平台。一开始的思路特别简单:把所有边缘节点的监控数据、运行日志、操作记录,全量回传到中心云的大数据平台,做统一的分析和管控。算完账才傻了。
全市分布的230个边缘节点,每个节点每天产生12G的监控和日志数据,按专线带宽的成本算,一年光传输费用就要花18万。更要命的是,只要节点所在的园区出现网络波动,中心云的监控面板上,对应节点的状态直接变成灰色,连个实时的运行数据都收不到,运维坐在指挥中心里,根本不知道现场是断网了,还是节点真的挂了。
后来他们把整个架构反过来改了。
把80%的异常判断逻辑下沉到边缘节点本地。比如节点检测到自身温度超过75度、磁盘占用超过90%、网络连续断连超过10秒的时候,先在本地触发自动清理缓存、降负载、重连网络的动作,只把需要人工介入的关键告警,通过低成本的窄带通道回传到中心平台。全量的日志和监控数据,存在节点本地的存储里,等网络空闲的时候再慢慢同步。
改完之后,整体的带宽成本直接降了70%,断网的时候中心侧也能收到节点最后一次上报的状态信息,不会对着满屏的灰色状态瞎猜。上次碰到一个园区的运营商基站升级,公网IP整体变更,所有之前配了固定连接的节点,靠着本地的自动重连脚本,两分钟就自动接入了新的网络通道,连运维的告警群都没惊动。
你说这事闹的,要是当初硬抱着全量回传的思路不改,那天说不定又要跑现场爬机柜,麻烦园区保安帮忙按重启键。
落地时别一开始就追求大而全
现在市面上讲边缘运维的方案,上来就是“全栈统一管控”“零信任安全接入”“AI智能运维分析”,听着特别唬人。真的落地过的团队都知道,一开始就追求大而全的平台,最后大概率会变成没人用的摆设。
南京本地有个做智慧停车的客户,之前管理全市320个公共停车场的边缘节点。最开始找了个厂商搭了一套全功能的边缘运维平台,花了快三个月,把资产盘点、日志分析、自动化巡检、远程配置的功能全做进去了。结果上线才发现,很多老停车场的网络带宽只有2M,连平台要求的agent都装不上,硬装上去之后,节点的CPU占用直接涨了40%,影响了停车场收费系统的正常运行。
我当时陪着他们的运维团队蹲在新街口停车场的机柜旁边拆设备,夏天的蚊子咬了好几个包,就为了测那个agent的CPU占用,现在想想都觉得闷热。
后来他们把平台的功能砍到只剩两个。
第一个是节点离线告警,只要节点连续5分钟没上报心跳,就第一时间给对应区域的运维发消息,别等车主扫不开码、缴费失败了才收到投诉。第二个是基础的远程重启能力,碰到节点假死的情况,不用大老远跑现场,在手机上点一下就能触发重启。
就这两个功能,上线之后,运维的现场出差量直接砍了72%。剩下的出差,基本都是碰到电源被拔、硬盘物理损坏这种真的需要上门处理的情况,跑一趟也认了。
真的,做边缘计算节点运维管理,别端着工程师的架子。
别信那些吹得天花乱坠的概念。
先把最痛的问题解决了——节点挂了能第一时间知道,不用每次跑现场爬机柜。这比什么高大上的技术架构都实在。
路要一步一步走。
现场的坑,总得一个个踩。