监控告警不该是团队的无效噪音
上周三凌晨两点十七分,我手机弹了条微信。是阿凯,在雨花台区做本地生活系统运维的老伙计。内容只有三个字:“想杀人。”
等他爬起来连完VPN查完所有日志才发现,那条把他从床上炸起来的最高级告警,是测试环境的Redis内存比阈值多飘了0.2G。跟线上业务半毛钱关系没有。他说当时盯着屏幕,连砸键盘的力气都没了。
运维深夜接告警电话的真实场景 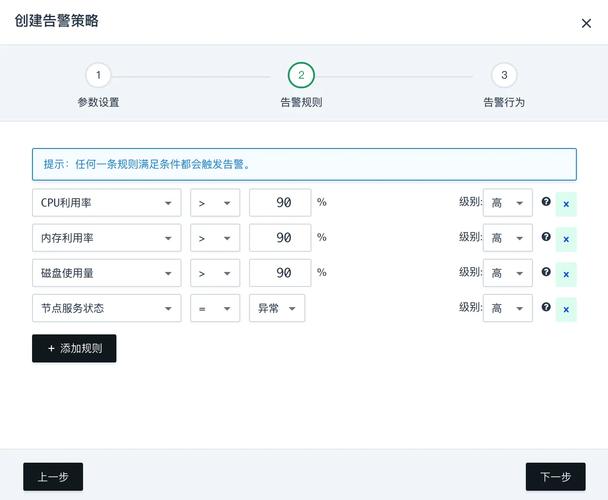
电商大促期间告警规则配置后台截图
告警泛滥是怎么把人搞麻木的
太多团队对监控告警的理解,从一开始就歪了。 总觉得接的指标越多,系统就越安全。CPU超10%要报警,磁盘剩15%要报警,甚至Nginx日志里多了几条404都要@全群。 算过账吗? 一天327条告警,299条都是无关痛痒的阈值飘移。换你你能每条都逐字看完?别吹什么职业素养。人的注意力是有额度的,连续被无关信息轰炸半个月,再看到告警弹窗的时候,第一反应不是“是不是出问题了”,而是“这又是哪条破规则乱弹的”。别拿阈值当万能解药
很多人搞监控,上来就拍脑袋定阈值。 CPU超过70%报警,响应时间超过200ms报警,内存使用率超过80%报警。 从来不想这些阈值定得合理吗?跟真实的业务影响挂钩吗? 之前接触过一个做生鲜电商的团队,去年618大促的时候,把订单接口的响应时间阈值设成了200ms。结果峰值流量上来,正常的波动就比阈值高了30ms,半小时弹了412条告警。最后值班的人实在烦得不行,直接把这条规则关了。 巧的是关完不到2小时,数据库连接池打满,真实的订单接口超时了。因为规则被关,根本没触发告警,等发现的时候,已经有1200多个用户付了钱看不到订单。算下来直接损失快30万。 所有脱离业务影响的告警阈值,本质都是在给团队制造无效工作。