Kubernetes多集群管理实践踩坑与落地
去年Q3,公司接了两个新收购业务线的容器化迁移需求,加上之前华东、华南两个自建的生产集群,我们运维组突然要同时管四个完全独立的K8s集群。
最开始图省事。
直接把四个集群的kubeconfig全导到每个运维同学的笔记本里,谁要操作就自己切上下文。结果入职刚满两周的小周,本来要给华南测试集群改个测试用的ConfigMap,熬夜赶版本熬得眼发花,手滑切到了华东生产的上下文,直接把支付服务的数据库连接串给改了,接口挂了20分钟。
真的痛。
那时候整个组在会议室复盘,所有人都拍桌子说,这破操作方式再也不能用了。
多集群不是把kubeconfig堆一起就行
很多人对多集群管理的第一认知,就是把所有集群的kubeconfig拼到一个文件里,切来切去就完事。真的落地过才知道,这是最原始、风险最高的方式。
我们当时踩的坑远不止切错上下文这一件。
没有统一的权限管控,谁拿到kubeconfig就能在所有集群里随便操作,甚至能删Namespace,审计日志散在四个集群的etcd里,出了问题要查是谁操作的,得挨个集群翻日志,翻到天亮都不一定能找全。要给所有集群的某个公共Namespace打同一个NetworkPolicy,得一个一个登上去敲命令,敲到第三个就开始犯困,敲错一个端口都没人能及时发现。
哦对,我们当时甚至试过给每个集群的上下文加不同的颜色标识,让大家切的时候能一眼看出来当前所处的环境,结果还是架不住有人熬大夜的时候脑子转不动,手滑点错。
我们最后摸出来的落地路子
最开始我们也想着要不要直接上某个商业的多集群管理平台,销售吹得天花乱坠,说什么一键多集群调度、跨地域容灾全搞定。我们咬咬牙付了十几万的年服务费,搭起来才发现,大部分功能我们根本用不上。
四个集群的业务完全隔离,收购来的两个业务线甚至有自己的独立运维团队,我们根本不需要跨集群调度,也不需要什么弹性溢出。
最后我们把那套商业平台给停了,自己搭了一套轻量的方案,前后花了不到一周。
第一步先把身份管控统一了,对接公司的SSO系统,用OIDC做身份校验,再也不把长期有效的kubeconfig发给个人。要操作集群的时候,直接通过统一运维门户申请,生成的临时kubeconfig有效期只有2小时,权限也按最小粒度分配,运维同学只能操作自己负责的业务Namespace,连集群的节点都看不了。
然后我们搭了Prometheus联邦,把四个集群的指标、日志、告警全聚合到同一个面板里,再也不用登四个Grafana挨个查。公共的配置比如Ingress的默认证书、公共的CA Secret,我们用Karmada的PropagationPolicy做批量下发,模板写好一次,选好要同步的集群范围,10秒就能推完全部目标集群。
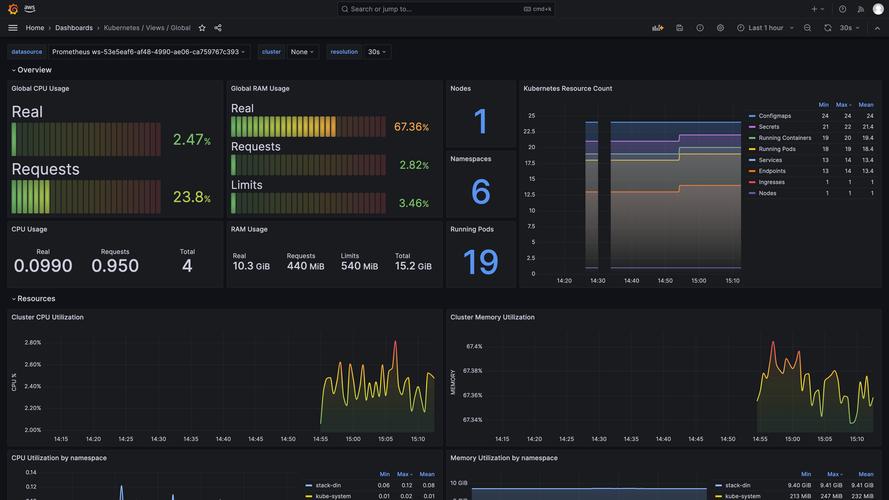
上次我们要更新所有集群的Ingress默认证书,搁之前得挨个登上去改,至少要两个小时,还得反复检查有没有漏的集群。现在点一下按钮,全搞定。
别被网上的多集群方案吹晕了
说实话,我们最开始也被各种博客吹的多集群联邦给晃了眼,觉得不上个跨集群统一调度,都不好意思说自己玩K8s玩得好。
结果真落地了才发现,跨集群调度的复杂度,比你多搭两个备用集群高十倍都不止。
除非你真的有跨地域容灾、业务弹性溢出的硬需求,不然真没必要上来就搞那套复杂的东西。我们现在四个集群用了快一年,跨集群的调度需求?一次都没出现过。
不过话说回来,多集群管理的核心从来不是什么高大上的技术,而是先把最容易出事故的环节堵上。你要是连操作的时候切错环境的问题都解决不了,谈什么统一调度、容灾备份都是白扯。
现在我们组每个新人入职,第一件事就是给他讲之前小周改崩生产的那事儿,再给他演示一遍临时kubeconfig的申请流程。
哦对,之前买的那套商业平台,我们已经停了快半年了,每年省的十几万服务费,全组出去团建玩了一趟。
真的,多集群这事儿,从来没有什么标准答案。别上来就堆最复杂的方案,先摸清楚自己的真实需求,能少走至少一半的弯路。