数据库索引不是免费的提速券
上周帮朋友排查线上慢查询,翻到执行计划的那一刻,我差点把键盘掀了——他给一张日增30万行的订单表,给三个普通业务字段全加了单列索引,以为能靠这个把查询拉到毫秒级,结果写请求卡到超时。
谁都被教过,查询慢就加索引。但没人跟你说透,加进去的每一条索引,都是要实打实占资源的。
数据库B+树索引分裂过程示意图 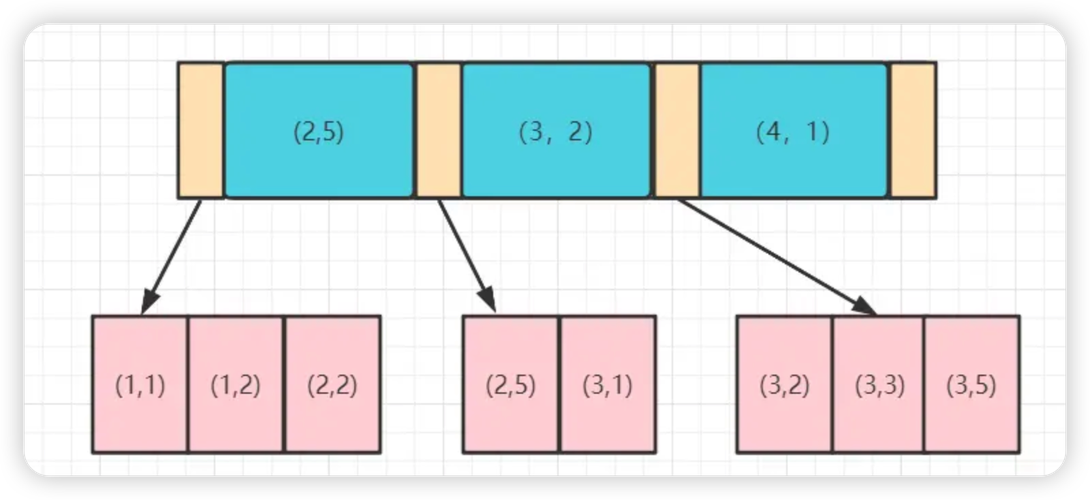
联合索引最左匹配规则示意图
索引不是加得越多越好
很多人对索引的认知还停留在“查询加速工具”,完全忘了它的另一面——每多建一条索引,所有写操作的成本就会同步涨一截。 你往表里插一条数据,数据库要做的事不只是把行数据写到对应的表空间页里。所有关联的索引,都要同步完成新键值的插入、节点排序,碰到页填满了还要做分裂,旧页的合并清理更是躲不掉。 刚才那个朋友的场景,三个单列索引,每次插入一条订单,就要同时维护三棵独立的B+树。本来毫秒级就能完成的写操作,硬生生拖到800毫秒。 谁遭得住。最容易踩的联合索引顺序坑
我见过太多人,联合索引建完就扔在那,根本不管字段顺序。 真的,每次看到建索引的SQL日志,我都想把执行计划导出来给当事人看看。之前碰到过一个场景,要按“用户ID+订单状态+创建时间”查某个用户最近的已支付订单。有人上来就按创建时间、订单状态、用户ID的顺序建了联合索引,觉得创建时间是排序字段,放第一个查的时候快。 结果呢?查询的where条件先筛用户ID,根本匹配不上索引的第一个字段,直接走了全表扫描。 说白了,联合索引的排序逻辑是有严格优先级的:先按第一个字段排,第一个字段值相同的情况下,再按第二个字段排,第二个字段值相同,才轮到第三个。索引的顺序不是你觉得哪个字段常用就放前面,是要跟着查询的筛选逻辑走的。把最常用来做等值筛选的字段放最后,那这个索引基本等于白建。