上个月帮开电商公司的朋友救场。他们团队攒了三周的压测报告,拍着胸脯说系统能扛3倍日常峰值。结果大促开场3分钟,订单库直接锁死,付款页全是白屏。客服的投诉电话从0点开始响,到0点10分的时候,接电话的小姑娘嗓子都哑了。
被压测报告骗的三次
我蹲在他们运维的工位上翻了半小时压测记录,一眼就看出问题——所有压测请求带的用户ID,全是固定的12个测试账号。
请求打到服务端,本地缓存直接命中。
Redis的CPU使用率压到峰值的时候才7%,数据库的慢查询日志比平时工作日的还干净。这哪是压测,这是给服务器做免费按摩。

之前我还遇过更离谱的,某互联网公司的压测团队为了出好看的报告,把压测脚本里的超时时间全调到了10秒,只要接口没崩,不管响应多慢都算通过。最后报告写着系统能扛8万QPS,真上量的时候,用户点个按钮要转5秒圈,转化率直接掉了40%。
数字这东西,你想让它好看,方法总比困难多。
很多人从一开始就压错了对象
大部分团队对性能压测的理解,还停留在”把接口打到多少QPS就算达标”的阶段。
不对的。
真实的用户行为从来不是匀速发请求的。大促开场的10秒,用户会反复刷商品页看库存,看到优惠券就立刻点领取,领完跳结算页,付完款还要折回来看订单状态,中间随时可能切到别的页面。你拿固定的请求循环刷,根本摸不到系统真正的瓶颈在哪。
我见过最夸张的压测方案,为了凑高QPS,把所有非核心接口的流量全掐了,就压下单接口,最后得出结论”系统能扛10万QPS下单”。结果真上线的时候,推荐服务先扛不住挂了,用户在首页刷不出商品,哪来的下单流量?
压测的时候一定要把全链路的依赖水位摸清楚。下游的支付渠道接口限了多少流?对象存储的带宽够不够撑住峰值的图片加载?甚至机房的出口带宽会不会在流量上来的时候被运营商掐脖子?这些环节你不压,等真出问题的时候,全是炸点。
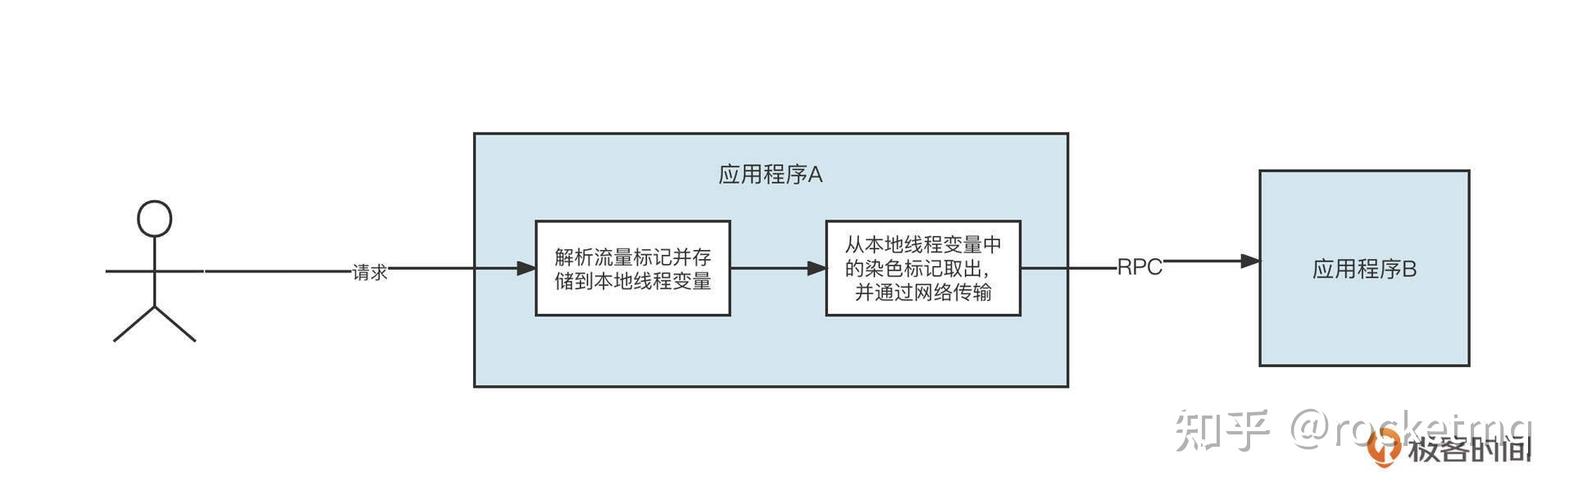
哦对,还有个容易被忽略的点:压测的请求别直接打到生产库。之前有个团队图省事,压测的时候把测试数据直接写进了真实的订单表,大促前清理了半天才清完,差点耽误上线。现在成熟的方案都会给压测请求打个特殊的标记,流量走到哪,对应的测试数据就自动隔离,根本不会碰真实的业务数据。
压测完的报告别只看最大QPS
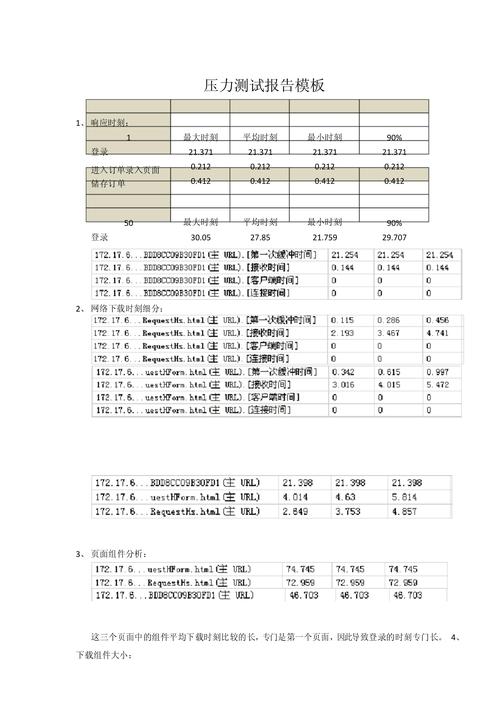
说实话,我现在看压测报告,从来不会第一时间找”最大支持QPS”那行字。
我会先翻99分位的响应时间。
平均响应时间150ms看起来很漂亮,只要最后1%的请求响应时间能到8秒,这部分用户就是那些在关键操作上卡住的人。哪怕占比只有1%,对应的就是几千个要跑过来投诉的付费客户。谁会管你的平均数字有多好看?转圈圈的时候,用户只会直接关掉页面去竞品家买东西。
然后还要看压到峰值的时候,那些藏在后台的资源指标。数据库的连接池是不是快被占满了?应用服务器的Full GC是不是开始频繁出现?消息队列的堆积是不是已经超过了平时的阈值?这些东西不会写在光鲜的汇报PPT里,但真到流量峰值的时候,任何一个指标超了,都能让整个系统直接瘫掉。
别觉得压测是开发或者测试的事。运维得盯着资源水位,产品得对着真实用户路径核对压测脚本,甚至客服都得参与——毕竟真出问题的时候,第一波接用户怒火的是他们,他们最知道哪个环节卡了最容易引发投诉。
上次那个电商团队的坑填完之后,第二次补压的时候,他们直接把去年大促的真实用户点击流日志导出来当压测流量模型,刚把流量拉到日常峰值的1.5倍,就发现库存服务的线程池直接打满了——原来之前的库存扣减逻辑,每次扣减都要同步调一次风控接口,这个环节之前的压测根本没覆盖到。
改完批量扣减的逻辑,第三次压测顺顺利利。到今年大促当天,系统扛住了日常4倍的流量,连个高危告警都没弹。
真的。
别在压测上偷懒。