上周去南京1024园区找老同事撸串,他啃着烤筋跟我吐槽,说上周刚把跑了3年的单体系统拆成微服务,结果上线第一周,运维同事的告警电话比他过去3年接的都多。
谁懂啊。
最开始他们团队只有3个后端,写的就是最朴素的SpringBoot单体,打个war包扔到Tomcat上,数据库就一个MySQL实例,当时社区团购的业务刚起,高峰一秒200请求,稳得像老黄牛。那时候上线根本不需要走什么三层审批,三个人对着需求文档拍板,打包上传服务器,5分钟就能全量上线,出问题了直接SSH登服务器看日志,半小时就能定位根因,连值班的运维都能跟着摸鱼。
不是单体老了,是团队跑不动了
很多人对架构演进的误解,就是觉得单体系统是落后的,必须要换成分布式、微服务才算先进。真不是。
老同事他们的系统,最开始3个人维护的时候,哪怕代码里全是复制粘贴的逻辑,也没人说重构,毕竟业务跑的快,用户投诉少,比什么都强。什么时候开始不对的?团队从3个人涨到28个,产品功能从最开始的10个,涨到120多个,订单、库存、用户、支付全堆在一个代码库里。
最开始改个库存扣减的逻辑,要拉产品、订单、支付三个组的人开一下午对齐会,就怕改崩了别的模块,连平时最摸鱼的测试同事都攥着测试用例表,就怕漏了哪个关联场景。上线更夸张,每次发版要等所有组都把代码提完,半夜12点开始打包,一次出问题,所有人都得爬起来回滚。
太磨人了。
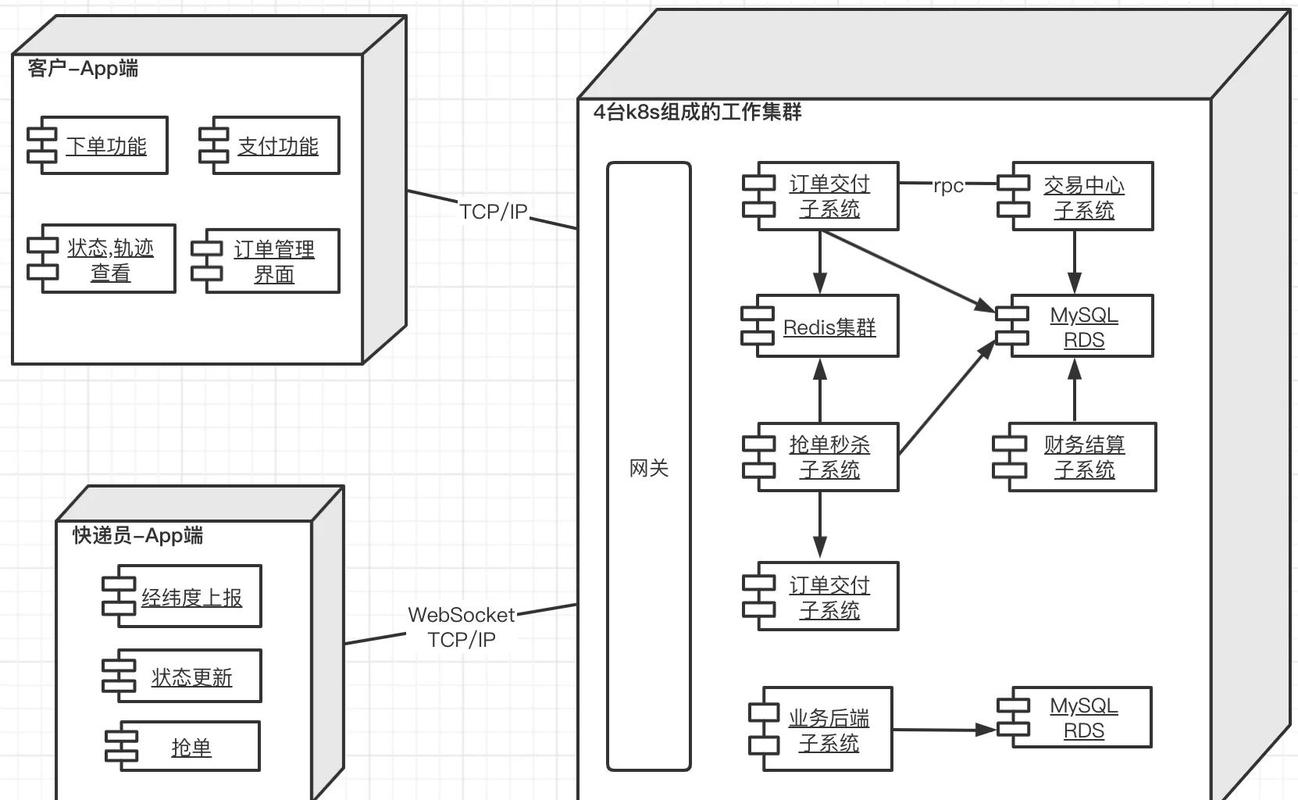
他们当时想拆服务,根本不是因为单体扛不住流量,是大家改代码改的累了,开对齐会开的烦了,说白了,是原来的协作模式,配不上现在的团队规模了。
拆服务的坑,全是没算到的协作成本
当时老同事他们照着网上的教程,把订单、库存、用户全拆成独立服务,搞了Nacos注册中心,搞了SpringCloud网关,甚至还跟风上了服务网格。说真的,那时候他们团队的技术文档写的可专业了,架构图画的五颜六色,连去给投资人做汇报的时候,都要指着图讲半天”分布式架构的高可用性”。
结果上线第一周就踩坑。
原来单体里调用库存扣减接口,就是个本地方法调用,耗时不到1毫秒,拆完之后要走内网网络,高峰期网络抖一下,订单服务就超时,用户付了款没生成订单,投诉电话直接把客服打爆。更头疼的是,原来查一个问题,直接看单体的日志就行,现在要跨3个服务查链路,链路追踪的配置还没调好,有时候查一个问题要花3个小时,比之前在单体里找bug慢了6倍。

最有意思的是,他们之前做架构预算的时候,只算了服务器要多买几台,中间件的授权费要花多少钱,根本没算协作的账。原来一个后端工程师,从需求评审到上线,全流程自己就能搞定,2天就能交付的需求,现在拆完了,改个订单接口要找库存组对齐接口参数,要找运维申请链路追踪的权限,要找测试组排测试用例,前前后后要花1周时间。
说实话,很多团队的架构演进,就是被这种隐形的协作成本拖死的。
好的演进,从来不是一步到位的
后来老同事他们踩了半个月的坑,终于醒过神来,开始调整方案。
没有一下子把所有模块全拆出去,而是先把最核心的支付模块拆出来——毕竟支付出问题是直接影响钱的,优先保障这个模块的稳定性。然后给所有跨服务的调用加了降级和兜底,比如库存接口超时的时候,先把订单落库,等库存服务恢复了再异步核对,实在核对不上的,就走人工客服补单。
甚至他们还搞了个过渡方案:剩下还在单体里的模块,先在代码库里划清楚模块边界,写代码的时候就按未来要拆的服务边界来,不让大家随便跨模块调私有方法,先把代码的协作边界理顺,等团队对新的协作模式适应了,再慢慢把代码拆成独立服务。
架构演进的核心从来不是技术栈的新旧,而是能不能匹配当下团队的协作效率。
现在他们团队20多个人,没有上什么高大上的服务网格,就是简单的注册中心加网关,跨服务的调用都配了合理的超时时间和降级策略,上线频率从原来的1个月1次,变成1周3次,出问题的概率反而比之前用单体的时候还低。
你说这是教科书里的微服务吗?好像也不是完全照着模板来的,但就是好用。
很多时候大家追的那种”完美架构”,其实都是技术人的自嗨。业务跑的顺,团队不内耗,用户少投诉,比什么架构图都管用。