上个月跟某券商运维组的人吃饭,一桌人半开玩笑说,现在值班最怕的不是出故障,是半夜告警响起来的瞬间——手机震得跟过年抢红包似的,点开一看三百多条,一半是关联触发的无效告警。
这事我跟不下十个运维团队聊过,踩的坑五花八门。
很多人对AIOps告警降噪与根因定位的第一印象,就是厂商吹的”一键消警、秒级找根因”,真落地了才发现完全不是那么回事。
告警降噪不是把告警关了
我见过太多运维团队走的弯路:刚上AIOps的时候,为了让告警数量”好看”,直接把所有非核心链路的告警阈值往上调30%,或者干脆把一类关联告警直接屏蔽。结果呢?真出问题的时候,该报的警不报,值班的人盯着监控面板干瞪眼,连故障出在哪都不知道。

告警降噪的核心目标永远不是”减少告警数量”,而是”减少值班人员的无效工作量”。说白了,就是把那些”已经知道会连锁触发、不需要人单独处理”的告警归成一类,只推最核心的那一条给值班人员,剩下的存在后台,等需要追溯的时候能查到就行。
就像之前听电商的朋友吐槽,大促期间数据库慢了0.2秒,能连锁触发十几条告警:应用超时、接口熔断、前端报错、用户投诉预警……以前值班的人要一条条点进去看,花半小时捋清楚根源是数据库的小波动,现在AIOps把这些关联告警自动归成一组,只推”数据库延迟异常”的核心告警,值班的人直接去查数据库就行,省下来的时间能多处理点真问题。
别觉得这是小事。我算过,一个中型互联网公司的运维组,每天要处理的告警少说有上千条,其中70%都是这种连锁触发的无效告警,光捋这些关联关系,每天就要耗掉两个值班人员一半的精力。
根因定位不是靠算法瞎猜
麻烦在于,很多厂商把根因定位吹得太神了。好像只要把监控数据喂进去,算法就能自动找出所有故障的根源,连运维人员的经验都不需要了。
真不是。
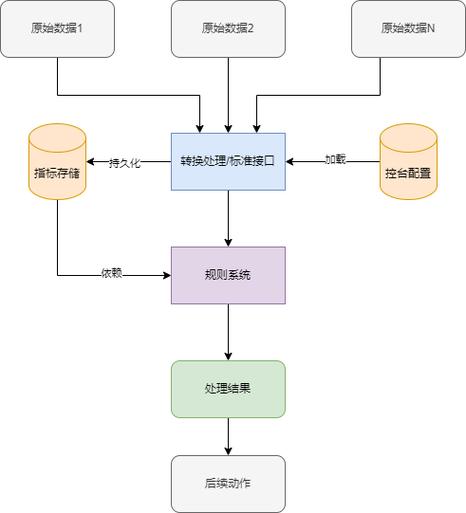
靠谱的根因定位,本质是先把企业内部所有监控数据的”上下文”喂给模型。哪台机器是跑核心交易的,哪台是跑离线计算的,哪条链路是用户支付必经的,哪条是内部报表用的——这些上下文如果没给对,算法再强也没用。
之前见过最离谱的案例,某公司买了号称行业顶尖的AIOps系统,上线第一周就炸了锅。算法把所有跑离线计算的机器的告警全推到了值班群,一天几百条消息。为什么?因为算法不知道这些机器本来就是吃CPU的,日常使用率就没低过70%,它只知道”CPU使用率超过80%就是异常”。最后运维组没办法,直接把那个告警群设成了免打扰——真出生产故障的时候,反而没人看了。
这事没那么玄。你想啊,老运维排查故障的时候,是不是先看核心链路的指标?是不是先查核心机器的状态?算法做的事,本质就是把老运维的这套排查逻辑固化下来,不用每次都靠人去记那么多规则。但前提是,你得先把这些规则给算法讲清楚,不然它就是个没头苍蝇。
别为了上AIOps而上系统
现在很多企业上AIOps,完全是跟风。同行都上了,我不上好像就落后了。花了大价钱买了系统,最后用得最多的功能还是”告警聚合”,所谓的根因定位,从来没人敢真的用来处理生产故障。
为什么?因为前期没梳理清楚自己的家底。连自己有多少个系统,多少条链路,多少个核心指标都没数,就指望算法帮你找根因,这不扯吗?
说白了,要是你家现在每月的告警量还不到一百条,值班的人花十分钟就能捋完所有关联关系,那真没必要花大价钱上AIOps系统。把现有的告警规则理清楚,把无效的告警阈值调合理,比什么都强。
别神化它。
也别贬低它。
我见过不少团队,先把自己的监控体系理清楚,把核心链路的关联关系梳理明白,再把这些规则喂给AIOps系统,最后效果好得很。值班的人不用再半夜起来捋几百条告警,真出故障的时候,系统直接把关联的指标和可能的根因列出来,值班的人花几分钟就能定位问题,比以前熬到天光大亮强太多。
说到底,AIOps告警降噪与根因定位从来不是什么高深的黑科技,它就是个帮人省力气的工具。工具好不好用,从来不是看算法有多先进,而是看用工具的人,有没有先把自己的问题想清楚。