Kubernetes是工程师手里磨出来的钳工台
2026-10-27 18:12:21
作者:
fawen
上周在软件大道某栋写字楼的负一楼食堂,碰到个连续加了三天班的后端工程师,端着黄焖鸡跟我吐槽,说当初老板拍板上Kubernetes的时候,大家都觉得是拿了尚方宝剑,现在倒好,一半的排查时间都耗在这玩意上。
别被厂商PPT里的全自动叙事骗了
厂商的销售会跟你拍胸脯,说上了K8s,所有运维问题自动解决。别信。
Kubernetes的核心调度逻辑从来不是帮你补应用的短板,而是把你应用里本来就存在的问题,按集群的放大效应给你透出来。你原来的单体应用,连健康检查接口都没写,直接丢到集群里,Pod一重启就挂,流量切过去直接打挂数据库。
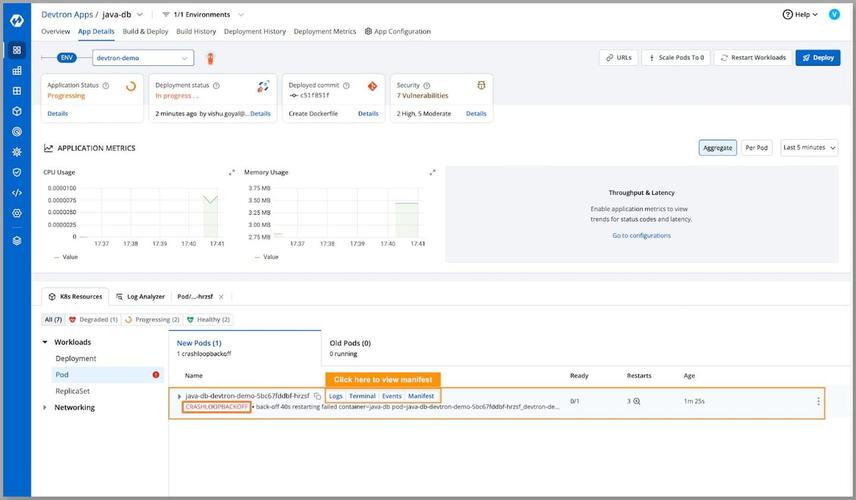 Kubernetes Pod健康检查配置错误报错截图
很多团队上来就照着网上的教程把三个master节点搭起来,etcd备份策略都没写,上个月碰到个团队,机房断电恢复之后,etcd数据因为没有定期快照,整个集群直接变砖,三个星期的业务迁移成果全没了,运维小伙子在工位上坐了半小时没说话。
说白了,这玩意从来不是开箱即用的自动售货机,你投币就出货。它更像个需要你反复调参数的精密机床,你对它的脾气摸得越透,它越能帮你省力气。
真正的成本从来不是集群本身的开销
很多人算Kubernetes的落地账时,总习惯只算表面的开销:服务器采购成本,云厂商收的集群管理服务费,甚至连跑监控组件占用的CPU都算得明明白白。
麻烦在于,这些看得见的成本,根本占不到总投入的三成。
你要投入的是团队的学习成本,是给存量业务做适配的改造成本。比如你原来的应用是写死了本地磁盘存日志的,现在跑在集群里,Pod是随时会飘走的,你要么改应用把日志输出到标准输出接采集链路,要么就得给每个Pod绑定固定的存储卷,这中间的改造量,够一个小团队扎扎实实忙俩月。
不少团队一开始为了图快,直接把原来的虚拟机镜像打包成容器丢进集群里,看起来是迁移完了,实际资源利用率比原来在虚拟机上还低——因为你容器里带了一堆根本用不上的系统依赖,调度的时候每个节点上塞不了几个Pod,钱花了,好处一点没捞着。
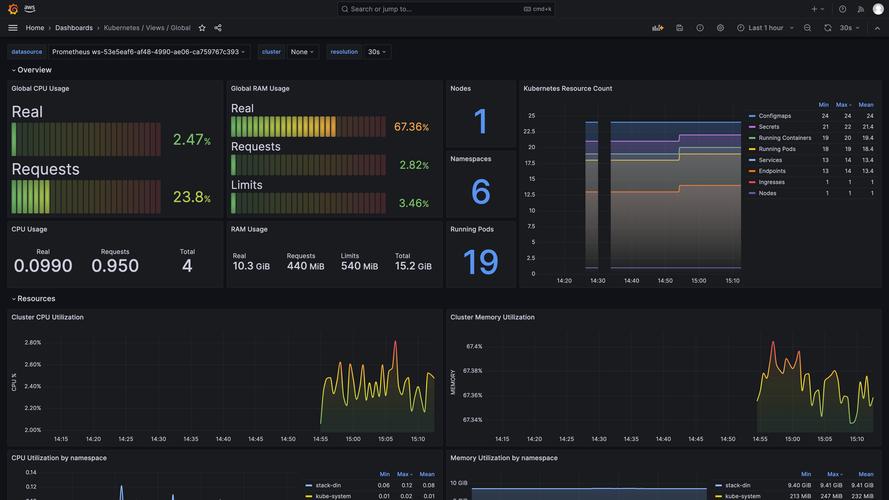 Kubernetes集群节点资源利用率监控看板截图
我上次碰到个团队,一开始为了省改造的麻烦,给每个容器都配了跟原来虚拟机一样的CPU和内存配额,跑了半年算下来,算上给云厂商交的集群管理费,比原来直接买虚拟机的成本高了四成,老板看着账单皱眉头,运维夹在中间两头难。
你说这冤不冤?
别为了用而用的冗余设计
 别为了用而用的冗余设计
很多团队上了Kubernetes之后,总觉得要把官方文档里写的组件全用上才叫专业。什么Istio服务网格,什么Knative无服务器框架,一股脑全堆到集群里,结果呢?本来一个简单的服务间调用,现在要过三层sidecar,排障的时候trace链路拉出来半米长,出了问题根本不知道是哪个环节卡壳。
Kubernetes本身只是个容器编排的底座,所有你往上堆的附加组件,都要算清楚你到底需不需要,而不是觉得别人用了你就得跟上。很多团队踩的最大的坑,就是把工具的价值放得比业务本身还高。
比如你团队总共就五六个研发,业务量一年也就涨个三成,整个集群跑十几个服务,根本用不到那种复杂的流量治理能力,老老实实写个Nginx配置,配个简单的HPA自动扩缩容,足够你用到业务规模翻三倍。非得跟着网上的风潮堆一堆组件,最后光维护这些附加组件的时间,比你写业务代码的时间还多,图啥呢?
不过话说回来,也不是说K8s不好。我见过不少团队,把集群的版本升级节奏跟紧了,把资源配额、监控告警、备份策略这些基础的东西做扎实了,原来要三个运维管的几十台虚拟机,现在一个人盯集群的监控看板就能搞定,新业务上线从原来要排一周的变更窗口,现在点个发布按钮五分钟就能全量上线,这时候你才会觉得当初花的那些功夫值。
上次在食堂碰到的那个小伙子,上周给我发消息,说他们团队花了两个月,把所有应用的健康检查、资源配额、日志链路都改完了,现在集群跑的稳多了,上周大促的时候,流量涨了三倍,集群自动扩了节点,整个过程没人半夜爬起来接告警。
他说现在才明白,当初踩的那些坑,根本不是K8s的问题,是之前总想着找个万能的工具,一劳永逸解决所有运维问题。
哪有这种好事。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
Kubernetes是工程师手里磨出来的钳工台
文章链接:https://www.itcdj.com/it/176.html