云原生可观测性体系建设一线实战笔记
2026-10-28 12:06:27
作者:
fawen
上周陪某电商客户排障,大促预热期接口超时,团队12个人盯着三个监控大屏,翻了40分钟日志,才发现是某个边缘节点的证书过期,把下游调用全堵死了。没人早发现。
我当时站在旁边看着,真的替他们急得慌——12个人,三个大屏,愣是没把数据串起来。
别把可观测性等同于装监控插件
很多团队刚上云原生的时候,总觉得可观测性就是把开源组件装完就算完事。Prometheus拉起来,Grafana看板挂上,Loki把日志收上来,链路追踪的Sidecar自动注入到所有Pod里,一套流程跑通,就对外宣布我们有了完整的可观测性体系。
结果呢?指标攒了几万条,告警堆了几百条,真出问题的时候,几百条告警同时炸响在企业微信里,没人知道该先看哪个。我们见过太多团队,监控系统的磁盘占用比业务日志还大,真排障的时候还是靠SSH登到机器上,用grep一行行翻日志。
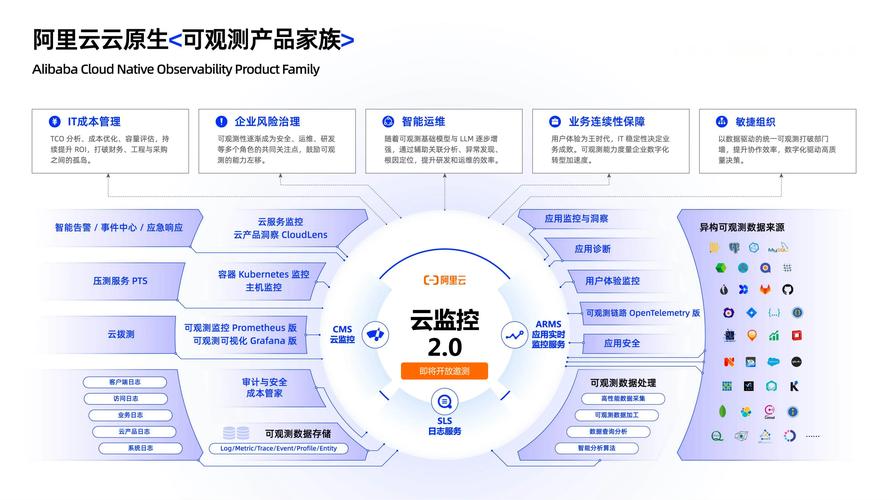 云原生环境多维度可观测数据关联界面
为啥会陷入这种尴尬?因为大部分人把可观测性的三个核心支柱——指标、日志、链路——当成三个完全独立的工具堆着。指标是运维团队盯的,日志是开发团队翻的,链路是SRE查的,三个系统的数据根本没打通。就拿那次证书过期的故障来说,指标层面只能看到调用延迟曲线陡增,日志层面能看到下游服务返回TLS握手失败,链路追踪里能看到所有请求都卡在了最前面的网关层,但这三组数据散在三个平台,你得自己手动对齐时间点,把零散的信息拼起来找根因。等你拼完,大促的预热流量已经跑丢了近三分之一。
别让可观测性变成团队的额外负担
真的很烦。
很多团队推可观测性建设,上来就给所有业务开发提要求:每个接口要自定义业务埋点,每个自定义错误要打全结构化日志,每个跨集群调用必须把全链路上下文透传到底。要求列了三页文档,开发团队怨声载道,嘴上答应着,上线的时候还是漏一堆埋点。
有个客户更绝,为了凑链路覆盖率,给所有Pod统一加了全量代理Sidecar,结果整体资源开销直接涨了30%,业务方直接把可观测性团队的需求打了回来,说再这么搞我们就不配合了。
其实根本不需要一开始就追求100%的覆盖率。先把三个最核心的场景摸清楚:支付相关的全链路追踪、核心接口的黄金指标(延迟、流量、错误率、饱和度)、跨服务调用的错误日志自动关联。就这三样,先跑通,比你铺100个没人看的监控面板有用多了。之前帮客户做落地的时候,我们没有上来就全量接链路,而是先把支付相关的12个核心服务的链路打通,把指标和日志按照TraceID做了自动关联——用户点了支付按钮超时,直接点一下链路里标红的报错节点,就能跳转到对应的错误日志和当时的指标曲线,排障时间直接从40分钟缩到了3分钟。
 支付链路端到端追踪节点关联日志示意图
可观测性的价值从来不是排障
 可观测性的价值从来不是排障
错了。
很多人对可观测性的认知,还停留在“出问题了能快点找到原因”的层面。但你仔细想,大促前一周,你通过可观测性数据发现某个服务的P99延迟已经比平时涨了40%,虽然还没触发告警,虽然用户暂时还没感知,但你提前扩容,把潜在的故障掐灭在萌芽状态,这比出了问题再抢修的价值大10倍。还有新功能上线做灰度的时候,你不用等用户投诉打客服电话,看一下新版本的错误率、调用延迟,就能知道这个版本有没有坑,不对就直接把流量切回来,反应速度比传统的测试验收快好几个量级。
别把告警阈值设得跟闹着玩似的。我们见过客户把CPU使用率到80%就发告警,一天能收2000条告警,运维团队直接把告警群设成免打扰,真出核心链路故障的时候反而看不到消息。正确的做法很简单,把所有告警按照影响面分级:核心链路的故障直接打运维负责人的电话,非核心的性能波动攒到周会同步就行,没人会被无效告警搞到麻木。
云原生环境下,服务拆得碎,调用链路跨集群跨可用区,你靠人脑根本记不住所有服务的依赖关系,对吧?可观测性体系不是什么高大上的技术项目,本质就是给你这套分布式系统装一套能听懂、会说话的神经系统。不用追求一步到位,先从最痛的排障场景切入,慢慢把数据打通,慢慢调整告警规则,用个半年,你会发现原来熬到凌晨三点排障的日子,真的能少很多。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
云原生可观测性体系建设一线实战笔记
文章链接:https://www.itcdj.com/it/209.html