数据库索引 被高估也被误用的性能工具
2026-10-29 09:42:28
作者:
fawen
上周跟一个做电商的开发吃饭,他说自己给订单表加了七个数据库索引,数据库查询速度还是没上去,反而写盘慢到每次发版都要等十分钟。
索引不是越多越好
说白了很多人对数据库索引的认知还停留在“查得慢就加个索引”,根本没算过写操作的账。每次insert、update、delete的时候,存储引擎不光要改主表的数据,还要把关联的所有索引树同步更新。每多建一个二级索引,写操作的随机IO开销就会跟着涨一截。
就拿那个电商开发举例子,他的订单表上有用户ID、订单状态、下单时间、收货手机号、支付渠道、优惠券ID、物流单号七个索引,每次用户付款生成订单的时候,存储引擎要在七棵B+树里分别定位、插入、调整节点,本来一次写操作的毫秒级响应,硬生生拖成了上百毫秒。
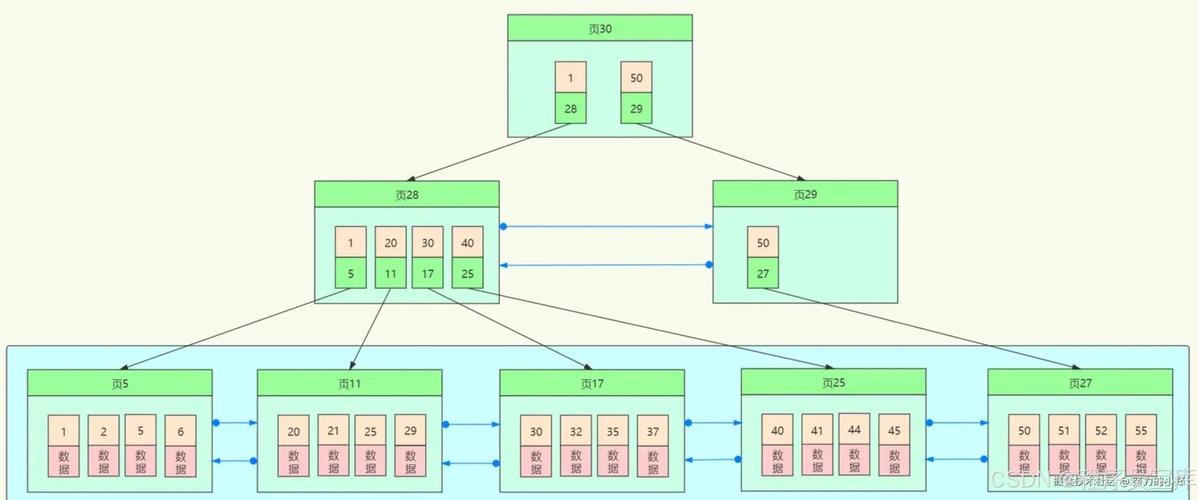 数据库B树索引结构图
很多人根本没注意到,索引不是免费的。它占的磁盘空间有时候比主表还大。我之前见过一张千万级的用户表,主表数据占了12G,上面的五个二级索引加起来占了18G。备份的时候光导索引数据就要比主表多花一半时间。
麻烦就在这。很多团队上线前赶需求,为了应付慢查询直接堆索引,根本没人回头梳理哪些索引是三个月前临时加的、现在已经没人用了,等到磁盘告警的时候才发现大半空间都被没用的索引吃掉了。
最容易加错的那类索引
说真的,我见过不下十个团队给区分度极低的字段建数据库索引。比如给订单表的“是否退款”字段建索引,给用户表的“性别”字段建索引。索引的效率本质上靠的是数据的区分度,区分度越低,索引的收益就越接近于零。
比如“是否退款”这个字段,95%的记录都是“否”,5%是“是”,你给它建了索引,存储引擎扫的时候还是要把95%的“否”对应的行全捞出来,跟直接全表扫描的开销差不了多少,反而多了一层维护索引树的成本。
上次有个开发跟我吐槽,说他给状态字段加了索引之后,查待退款的订单反而更慢了,查执行计划才发现优化器根本没走他建的那个索引。
白忙活。
还占空间。
 数据库索引区分度对比示意图
还有人喜欢给长文本字段建全字段索引,比如给收货地址、商品详情这种动辄上百字符的字段建普通索引,查的时候根本用不上前缀匹配,索引的过滤效果差到离谱,建了跟没建一样。之前见过有人给100位长度的地址字段建了全字段索引,光这一个索引就占了2G多的空间,后来改成了前缀长度20的联合索引,空间直接省了80%,查询速度还比之前快了不少。
还有一种常见的错,就是把联合索引的顺序搞反了。很多人建联合索引的时候,是按照自己手写查询条件的顺序来,比如经常查“用户ID + 下单时间”,就直接建(user_id, order_time),但如果有个查询是只按order_time筛范围,这个索引就完全用不上。这事没那么玄,核心就是最左匹配原则,但很多人把这个原则背得滚瓜烂熟,上线的时候还是会踩坑——因为他们根本没拉全线上的所有查询语句,就拍脑袋定索引顺序。
索引的真实代价从来不是查询速度
很多人聊数据库索引,上来就说怎么让查询从秒级降到毫秒级,好像索引就是纯赚的性能工具。但实际上,你每从索引上拿一点查询收益,都要从写性能、磁盘空间、备份恢复速度、甚至主从同步的延迟里扣成本。
比如主从同步的时候,从库不光要回放主表的binlog,还要同步更新所有的索引树,如果索引建得太多,主从延迟就会跟着涨,遇到大促的时候,从库的查询延迟可能直接拉到几分钟,读流量切上去根本扛不住。
我之前跟一个做存储引擎的工程师聊天,他说很多团队对索引的态度就像年轻人买健身卡——办的时候想着能练出八块腹肌,实际上卡扔在抽屉里半年都不会去一次。那些建了之后半年没被用到的数据库索引,除了给写操作添堵,半毛钱价值都没有。
其实现在很多数据库都自带索引使用率的统计,跑个脚本就能把长期没用的索引捞出来删掉,但大部分团队根本没人做这个定期巡检。
太可惜了。本来这些索引占的空间、拖慢的写速度,本来可以用来存更多的用户数据,扛更多的并发请求。
上次跟那个加了七个索引的开发吃饭,他回去花了一下午,把三个没人用的索引删掉,又把两个区分度极低的索引合并成了一个联合索引,最后写操作的延迟直接降了60%,查询速度反而没掉。
你看。
根本不是索引越多越好。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
数据库索引 被高估也被误用的性能工具
文章链接:https://www.itcdj.com/it/244.html