上个月帮朋友的电商团队救场,大促前半小时,订单库的CPU直接飙到98%,监控上的慢查询数跳得像过年的鞭炮。
急死个人。
技术团队围着数据库控制台转了快二十分钟,有人已经开始喊要重启实例,我赶紧拦住——重启解决不了根上的问题,搞不好还会把正在写入的订单搞丢。
先定位慢因再动手
很多人碰到慢查询的第一反应,是把SQL复制到本地,跑个EXPLAIN看执行计划,然后对着索引列一顿加。
错。
本地跑出来的执行时间,和线上真实的执行时间根本不是一回事。线上的慢查询日志里记录的耗时,包含了锁等待、磁盘IO排队、网络传输的全流程成本,不是你本地无锁环境下跑出来的理想值。
上次那个团队碰到的第一个慢SQL,就是查用户最近的订单列表,本地跑只需要20毫秒,线上却要等7秒。盯着执行计划看了俩小时,才发现是前面有个跑了8秒的大事务,正在批量更新所有待发货订单的状态,这个查询就在那干等锁释放。
锁等待导致的慢,根本不是查询本身的问题。
要是当时急着给这个查询加索引,不仅解决不了锁等待的问题,还会额外增加那个大事务的写入开销,搞不好锁等待的时间会更长。
索引不是越多越好
说出来你可能不信,那个团队的订单表上,一共建了12个索引。
每次插入一条新订单,数据库要同步维护12棵B+树的索引结构,原本1毫秒就能完成的写入操作,硬生生被拖到了20毫秒。大促的并发量一上来,写入的请求排着队等锁,连接池很快就被占满。
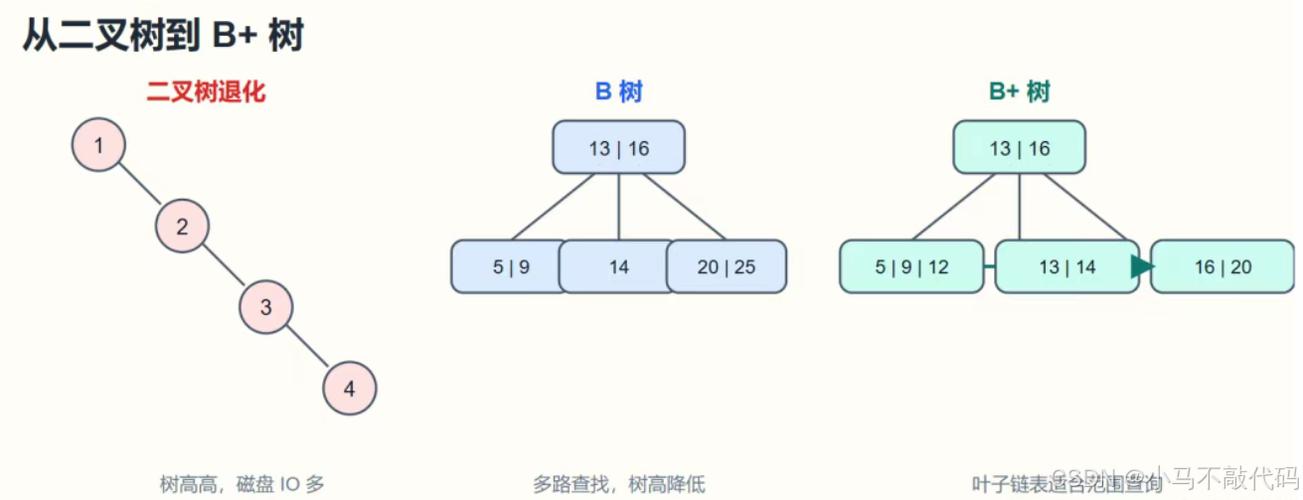
更离谱的是,这里面有3个索引根本从来没被用到过。其中一个是给“订单状态”字段建的单列索引,这个字段总共就7个可选值,区分度连1%都不到,优化器根本不会选这种低区分度的索引,纯纯占磁盘空间,还拖慢所有写入操作的速度。
说实话,我见过太多开发在建索引的时候图省事,WHERE子句里出现哪个字段就给哪个字段加索引,从来不管字段的实际区分度。
真正有用的复合索引,是按照字段的区分度从高到低排的,不是按照你写SQL的顺序排的。
比如查订单的时候,“订单号”是唯一的,区分度最高,就应该放在复合索引的最前面,后面再依次跟上订单状态、创建时间这些低区分度的字段。反过来要是把创建时间放最前面,这个索引基本就废了——毕竟一天内可能有几十万条同时间创建的订单,过滤效果差到离谱。
别让烂逻辑拖垮数据库
排查到最后,我们发现那个把CPU打满的SQL,本质上就是开发写的逻辑有问题。
为了给前端展示用户的订单列表,开发写了个SELECT *的查询,没有加LIMIT条件,直接把用户过去三年的所有订单全捞出来了,实际上前端只需要展示最近的3条。
离谱吧。
这种SQL哪怕索引建得再完美,只要查出来的数据集太大,跨节点传输的成本就摆在那。尤其是跨可用区部署的数据库,光数据传输的耗时就能占整个查询时间的一半。
之前还碰到过一个更夸张的,为了查订单对应的物流状态,开发写的SQL把1200万行的物流表和2000万行的订单表做了全表关联,没加任何关联的过滤条件,这个SQL跑了40分钟,直接把主库的IO占满,连带影响了整个用户端的浏览功能。
很多人总觉得数据库慢是数据库本身的性能不行,要换更高配置的服务器,其实大部分时候,慢的根源都是写得太烂的SQL逻辑。
那天我们花了四十分钟,删掉了5个没用的索引,把那个没有LIMIT的查询加上了分页限制,又把那个跑了8秒的大事务拆成了小批次执行,数据库的CPU很快就降到了30%以下。
大促最后顺顺利利跑完,当天的GMV比去年涨了40%。
哪有什么神仙优化技巧啊,无非是少点想当然的操作,多盯着实际的日志看而已。