分布式缓存一致性保障 那些踩过坑才懂的真实取舍
2026-11-02 00:01:21
作者:
fawen
上周跟个做电商的老朋友在咖啡馆碰了面,他刚从大促的值班状态里缓过来,眼下的黑青还没消。
他说大促零点的时候,有个用户付完款,刷新订单页,缓存里还挂着”待支付”的状态。用户反复点了三次支付,扣了三次钱。客服后台的消息直接堆了几百条。
折腾到凌晨三点,才发现是缓存更新的链路卡了一下,旧值没刷掉。
别上来就追求绝对一致
很多人一碰到缓存和数据库不一致的问题,第一反应就是要做”强一致”。
纯属想多了。
分布式环境下,网络是不可靠的,机器是会出问题的,你凭什么觉得两次跨节点的写操作,能永远保持严丝合缝的顺序?
大家熟到不能再熟的”先更数据库,再删缓存”的方案,本来是能覆盖90%的场景的。但架不住有个边角情况:你刚把数据库的值更新完,还没来得及走到删缓存的那一步,刚好有个读请求打进来,发现缓存里的值还在,就把旧值读出来,重新写回了缓存。
哦,这就麻烦了。
这个旧值会一直在缓存里待着,直到你设的过期时间到了才会被清掉。这中间哪怕你把数据库改了十次,缓存里还是最开始的那个老值。
我第一次碰到这个bug的时候,盯着监控看了三个小时,后背全是冷汗。
 分布式系统缓存与数据库写入时序冲突示意图
很多人看到这个坑,马上就说用延迟双删不就完了?
扯呢。
延迟多久?100毫秒?1秒?你敢拍胸脯说,你系统里所有的读请求,都能在你设的延迟时间内跑完?碰到个慢SQL,碰到个跨机房的网络抖动,碰到个JVM的Full GC,那个读请求走了两秒才回来,照样把旧值塞回缓存里。
很多人做技术选型的时候总觉得,只要我把所有可能的异常分支都覆盖到,就能写出一套永远不出错的系统,却忘了分布式环境下最不缺的就是你想不到的异常,网络会抖,机器会宕,线程会因为GC突然停住几百毫秒,这些东西从来不会按照你写的测试用例走。
那些被过度神化的方案
后来有人说,别自己删缓存了,直接订阅数据库的binlog,异步把缓存的更新动作做了不就稳了?
这话听着确实顺。毕竟binlog是数据库本地生成的,只要链路是通的,总能把更新事件传出去。
但binlog同步的链路天生就有秒级延迟。
你拿这个做个博客系统、做个商品的详情展示页,可能没啥问题。毕竟内容改了之后,晚个两秒显示,用户根本感知不到。
你拿这个做交易场景试试?
用户刚付完款,binlog还在消息队列里排着队,缓存里还显示”未支付”,用户手指一哆嗦,又点了一次支付。
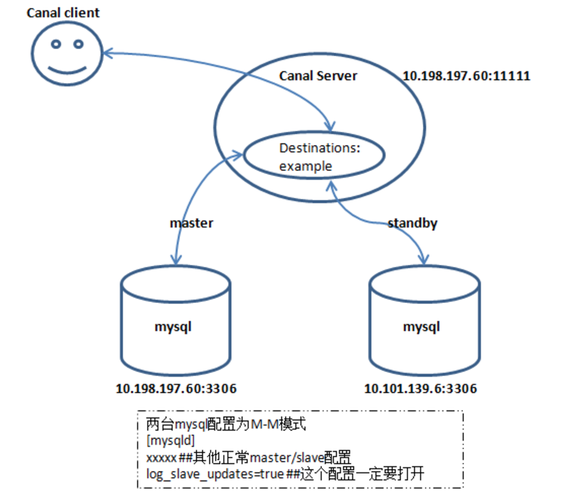 基于Canal的缓存异步更新链路流程图
还有人说,那干脆写的时候同时写缓存和数据库,不就完了?
更扯。
两个写操作跨节点,你根本没法保证顺序。线程A先把数据库的值改成1,正要写缓存的时候,线程B把数据库的值改成2,写完缓存也改成2。结果线程A的写缓存动作慢了半拍,把1又塞回了缓存。
最后数据库是2,缓存是1。
太糟心了。
真正落地的取舍从来都不漂亮
我见过的能扛住亿级流量的团队,没有哪个是死磕100%一致的。
人家都是拆场景的。
商品价格这种改的频率极低,哪怕偶尔有个10秒的不一致,也不会造成大损失,那就把过期时间设短点,靠过期机制兜底。
用户余额这种绝对不能错的,干脆就别把全量余额存在缓存里,读的时候直接走数据库的只读副本,哪怕接口慢个几毫秒,也比出资金问题强。
说到这你就明白,分布式缓存一致性保障从来不是靠某一个万能公式打天下,是你愿意为每个场景掏多少对应的成本。
之前有个团队,为了做所谓的”强一致”,每次写缓存的时候都要加个分布式锁,结果大促的时候,锁的竞争直接把接口的响应时间拉高了三倍。本来搭缓存是为了给数据库减负,结果搞的比直接查数据库还慢,上线俩礼拜就全拆了。我当时听他们的技术负责人吐槽,说本来想搞个完美方案,结果差点把大促搞砸,现在想起那堆锁的代码都头疼。
你说图啥呢?
还有个团队更夸张,为了抓那万分之一的不一致概率,专门搭了一套实时对账系统,每天扫一遍缓存和数据库的差异,自动触发修复。算下来一年的机器成本,够雇两个资深开发了。最后盘了盘过去三年因为缓存不一致造成的用户损失,连这个成本的零头都不到。
真的没必要。
很多人做技术方案的时候,总喜欢把所有可能的极端情况都列出来,然后为了覆盖这些极端情况,把整个系统搞的无比复杂。却忘了,大部分的极端情况,在你业务的整个生命周期里,可能一次都碰不到。
碰到了怎么办?
大不了人工修复嘛。
现在市面上吹的各种缓存一致性框架,听着特别高大上,你真拉过来用用就知道,那套东西的复杂度,够你团队消化好几个月,最后解决的问题,可能你设个短点的过期时间就能覆盖。
没人能做到完美。
对吧?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
分布式缓存一致性保障 那些踩过坑才懂的真实取舍
文章链接:https://www.itcdj.com/it/376.html