上周跟个做运维的老哥们喝酒,他吐槽去年公司硬上容器化,花小几十万买商业服务,结果一半老业务还跑在虚拟机上。运维团队反而要同时维护两套系统,加班比之前还多。
不是所有系统都适合塞容器
很多人对容器化的第一印象,就是装个Docker,把应用打包扔进去就完事。
不对。
那种跑了十年的老ERP,代码是二十年前的开发者写的,连完整的依赖清单都找不全,你硬要容器化,光排查动态链接库的兼容问题,就能耗掉两个工程师三个月。容器化的核心优势是环境一致性和弹性调度,从来不是为了把所有工作负载都硬塞进同一个壳里。
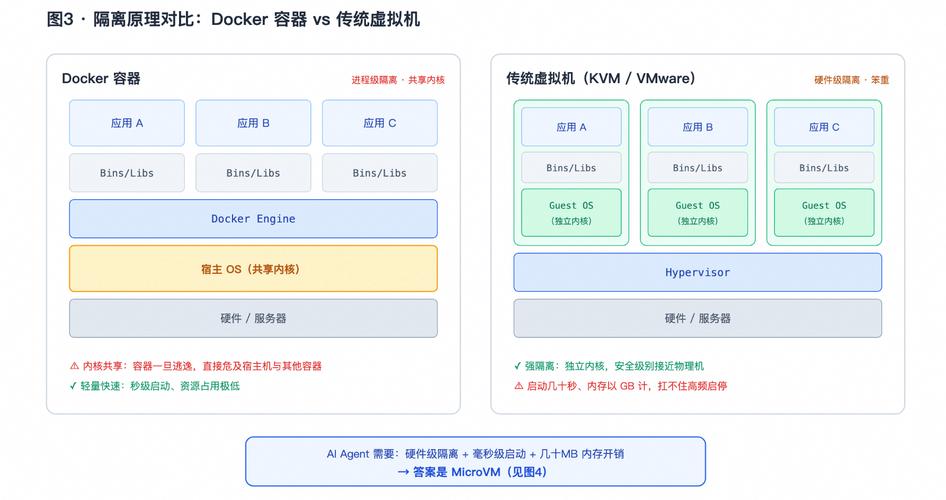
麻烦在于,不少技术负责人是看了同行的分享,觉得别人都上了,自己不上就落后,根本没算过自己的业务是不是真的需要弹性。比如那种一年只有大促才会有流量高峰的电商,平时流量平稳到CPU使用率都跑不满30%,你上容器的自动扩缩容,除了多掏点容器编排的运维成本,根本没什么实际收益。
还有那种内部行政系统,一年到头访问的人不超过五十个,你给它搞容器化,图啥?图镜像仓库里多存几个没用的tar包?
藏在容器化背后的隐性成本
很多人算容器化的账,只算买商业平台的license钱,算服务器采购的钱,根本不算人的成本。
原来的运维团队只会写shell脚本管虚拟机,现在要学K8s,要懂网络策略,要懂存储卷的挂载逻辑,要会排查镜像拉取失败的问题,这些培训的时间,踩坑的试错成本,都不是小数目。
容器的镜像安全是个很少有人提前说的坑。你随便从公共镜像仓库拉个基础系统镜像,可能里面藏着挖矿程序,要是直接用来跑生产业务,哪天服务器被别人拿去算比特币,你都找不到问题出在哪。

还有日志的问题。原来跑在虚拟机上的应用,日志直接写在本地磁盘,出问题登上去就能grep关键词。现在容器是随时会被销毁重建的,你要是没提前搭好集中日志采集体系,等Pod被调度节点踢掉,你连当时的错误日志都找不回来。
我之前碰到过一个团队,上线了三个月的容器化系统,出了一次线上故障,查了六个小时才发现,负责日志采集的DaemonSet早就因为节点重启挂了,所有的错误日志全存在被销毁的容器里,根本捞不回来。
别把容器化当最终目标

说实话,很多人对容器化的理解,还停留在“把应用打包成镜像能跑”的阶段。
这事没那么玄。
说白了,容器就是个更轻量的隔离环境,比虚拟机启动快,资源占用少,仅此而已。你要是把它当能解决所有技术债的银弹,那大概率要失望。
比如你原来的应用代码写得稀烂,一碰到并发就内存泄漏,就算把它塞进容器里,它该崩还是崩,不会因为跑在容器里就自动变好。
对吧?
不少公司搞容器化,最后变成了为了上K8s而上K8s,硬把原来一个能跑的单体应用,拆成二十多个互相调用的服务,结果链路追踪都没搭好,出个问题要跨七八个服务排查,效率比之前低了好几倍。
取舍从来都是技术落地的核心。要是你团队一共就三五个开发,业务也没什么弹性需求,其实根本没必要硬上复杂的容器编排体系,用docker-compose把几个服务打包跑在一台服务器上,足够用了。别去学大厂搞几十个节点的集群,你那点业务量,连集群的十分之一资源都用不满。
前阵子跟那个吐槽的运维老哥再聊,他说现在公司想通了,不再硬推所有业务上容器,先把几个流量波动大的核心业务迁过去,慢慢搭配套的监控、日志、安全体系,反而效率高了很多。
技术这东西,从来没有什么必须要追的潮流。
适合自己的,能解决实际问题的,就是好的。