没人真的想坐下来逐行读代码
上周跟几个做了五六年的后端聊,说到代码评审,所有人第一反应都是——又要拉群看那堆根本没注释的接口逻辑?
太耗时间了。你手里还压着三个要赶的需求排期,刚泡好的咖啡还冒热气,就被@到要评审别人提交的两百行业务逻辑,连上下文都得自己翻git记录倒推。

很多团队的代码评审最后都走成了形式:扫一眼有没有语法报错,连提交的逻辑分支都没点开,就顺手点了”同意通过”。没人觉得这事有什么错,毕竟大家都默认这是个额外的工作,是给别人的代码当裁判,没什么实际收益。
大部分团队把代码评审的价值,算成了”上线前找bug的最后一道闸”,但从来没算过这部分时间的投入产出比。大家总觉得花时间读别人的代码是亏的,却没算过因为漏看一个逻辑漏洞,后面要花多少时间填坑。
评审的代价从来不是读代码的那二十分钟
很多人吐槽代码评审贵,说读两百行代码至少要二十分钟,有这时间自己都能写半页新逻辑了。其实根本不是。
贵的是那些没被说出口的隐性成本。比如评审的时候大家都客气,看到有问题不说,怕伤和气,最后那个有问题的代码上线,出了线上故障,半夜爬起来改,那才是真的贵。
客气是最贵的。你在评审会上看到别人写的循环里嵌了三次数据库查询,明知道高并发下会把库打挂,但想到人家刚进组三个月,平时跟你对接也挺客气,话到嘴边就变成了”这个地方后面可以再优化下”,然后就过了。
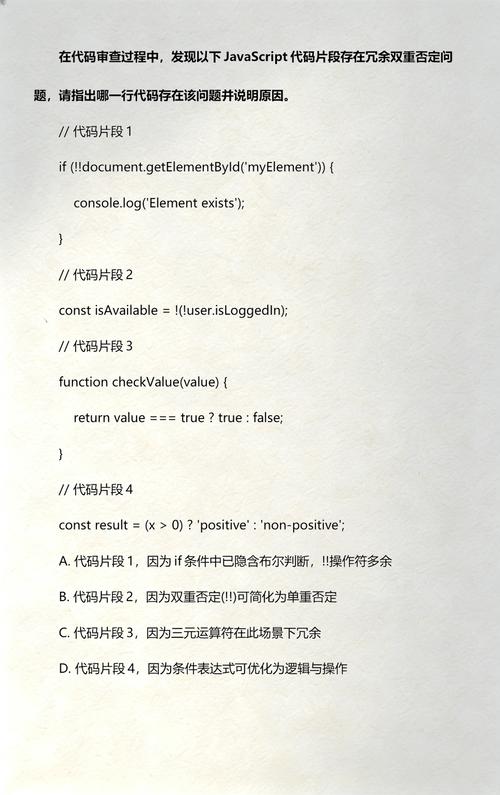
还有些团队走了另一个极端,把评审标准定得细到离谱:变量命名是不是符合驼峰规则,缩进是两个空格还是四个,注释占比有没有达到30%,拿个checklist一条条打勾。说白了,这些东西根本不需要人来评审,lint工具跑一遍就完事了。人在评审里要做的事,是工具永远做不了的。
能被工具自动校验的规则,永远不该占用人工评审的时间。人工评审要关注的,是这段逻辑是不是和团队之前定的服务边界一致,有没有把不该放在接口层的校验逻辑硬塞进去,有没有为了赶需求抄了网上的开源代码,连License风险都没考虑。
好的评审从来不是谁对谁错的辩论赛
我见过最舒服的评审场景,根本不是拉个会议室所有人坐成一排,对着提交的代码挑错。是两个写代码的人,凑在一块屏幕前面,提交的人顺着自己写的逻辑顺一遍,哪里是绕了弯路的,哪里是临时凑的应急方案,自己先讲清楚。看的人有疑问就直接问,不会上来就说”你这写的不对”。
没有上下级。没有考核。大家聊的是这个逻辑如果遇到极端的边界值会出什么问题,那个方案如果后面要加新的需求,改起来会不会太麻烦,而不是揪着某个变量的命名是不是符合团队的规范咬着不放。
之前有个做交易系统的团队,之前评审的时候总吵架:资深开发总觉得新人写的代码太粗糙,新人觉得资深的人总在挑语法细节。后来他们改了规则,评审的时候先不看代码格式,先问三个问题:你写这段代码的时候,有没有遇到什么拿不准的地方?这个逻辑如果出问题,最坏的影响是什么?如果后面要改,你觉得哪部分最容易出问题?就这三个问题,一下把评审的焦点从”挑错”拉到了”对风险的共同认知”上。
真正的代码评审,从来不是给写代码的人打分,是给整个团队的系统留一份共同的风险认知。新人写的代码有问题太正常了,评审的本质是把整个团队踩过的坑、定过的边界,通过逐行的代码传递下去,而不是等着新人自己踩坑学会。
不过话说回来,这事也没那么容易。很多团队做不好代码评审,根本不是大家不知道这些道理,是管理层总觉得评审的时间是”不产出代码的浪费时间”,总催着大家赶紧把评审点完,赶紧写新需求。
这种环境下。再好的评审规则也没用。