上周帮一个做连锁零售的朋友排查问题,他们12人的运维团队,一天要接3000多条告警。80%都是无效的。凌晨三点爬起来刷手机看告警,头发掉得比门店的临期商品损耗还快。
先搞懂你要AIOps解决的到底是什么
很多团队一上来就冲最炫的功能——自动根因分析、全链路故障自愈,仿佛买个大模型回来,运维的所有问题就能自动消失。
别笑。真见过。
去年有个做在线教育的客户,砸了快两百万上了一套号称”全智能”的运维平台,跑了三个月,误报率比用了五年的老规则引擎还高。最后全团队一致决定,把所有AI功能全关了,回到原来靠人盯监控面板的状态。钱打了水漂不算,大家对新工具的信任感直接跌到谷底,之后再想推任何自动化项目,没人愿意配合。
说白了,你连基础的数据底座都没搭好,扔个AI进去除了制造幻觉,啥用没有。就拿他们家的支付链路日志来说,一半的请求没带traceID,连请求是从哪个小程序入口进来的都查不出来,还想让AI自动定位是哪个节点出了问题?

说真的,这部分脏活累活没有任何捷径可走。你得先把所有监控指标的口径统一——比如”接口响应时间”到底是从请求发出去到收到首包的时间,还是到整个响应体加载完成的时间;得把半结构化的日志做清洗,把那些没意义的调试信息全删掉;得先靠人工把重复出现的告警规则先梳理一遍,砍掉至少70%的无效告警。等这些基础的有效数据攒够了,再喂给模型,才有可能跑出靠谱的结果。
别一开始就盯着最复杂的故障场景
我见过太多团队的AIOps项目,死在”眼高手低”上。刚把工具装好,就想直接上最复杂的自动根因定位功能,就像刚拿驾照就想跑F1赛道,不撞车才怪。
务实的落地路径真的没那么复杂。就从最简单的告警降噪开始做。
还是说回那个零售客户,我们帮他做的第一步,根本没碰什么复杂的模型,就是用最基础的聚类算法,把同源的告警做合并。之前某台服务器CPU飙高,会同时触发四个独立告警:CPU使用率超阈值、磁盘IO波动、服务响应超时、订单接口报错。四个告警分别弹给四个不同的运维,每个人都要手动查一遍,其实背后是同一个根因。合并之后,一天3000多条告警直接降到400多条,团队的告警处理效率提了60%。就这一个小功能,全团队乐了快一周——终于不用在大半夜被四个重复的告警连环call了。
等这个降噪的功能跑稳了,再慢慢往上叠能力。比如原来的规则引擎只能识别”CPU超过90%就算异常”,但模型可以识别”这台服务器平时CPU都是稳定在30%上下波动,今天突然升到60%,虽然没到90%的硬阈值,但其实已经是异常波动了”。这种对非标准化业务场景的识别,才是AI真的比传统规则强的地方。
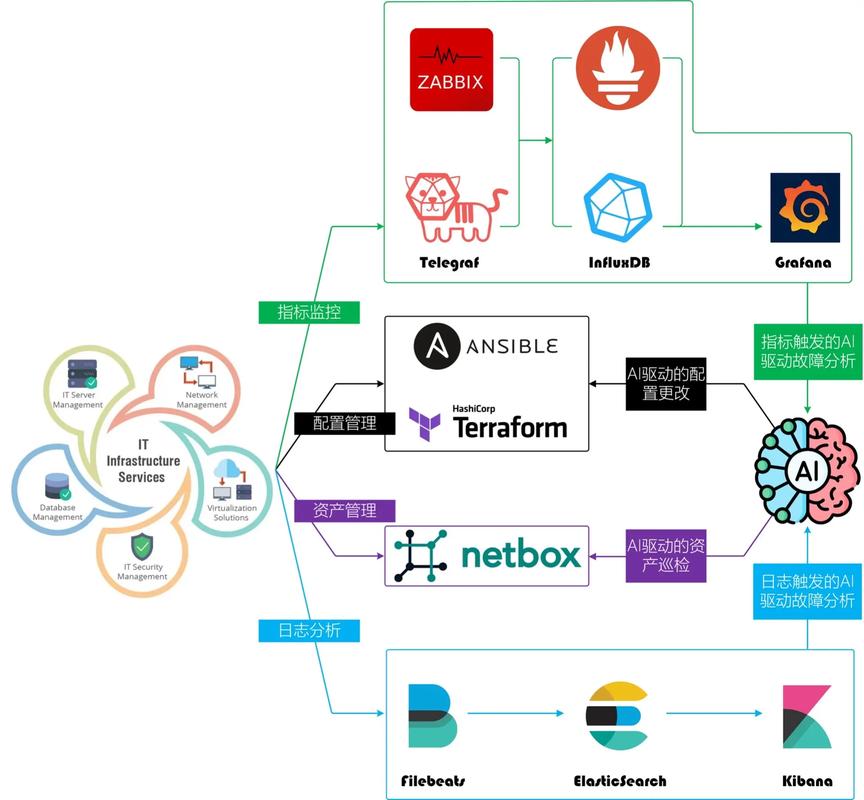
团队的认知对齐比技术选型重要一百倍
我做了这么多年技术编辑,见过太多AIOps项目做砸,根本不是技术选型的问题,是从一开始三方的预期就根本不在一个频道上。
业务方觉得,上了AIOps,以后出故障全靠AI自动处理,凌晨再也不用喊运维起来值班;运维团队觉得,这东西就是领导拍脑袋搞出来给大家加活的,原来的规则用得好好的,为什么要折腾新东西;管理层觉得,花了几百万上的系统,三个月就得看到”运维团队规模缩减30%”的降本效果。
最离谱的是我去年接触的一个制造企业,IT负责人在项目启动会上直接把目标念成”上了这套AIOps系统,运维团队要精简三分之一”。消息传到运维群里,当天测试环境的账号就被大家集体锁了——你要裁人,还想让我们配合你把工具用熟?可能吗?
真正能把AIOps用起来的团队,都是从一开始就把预期拉得特别平:这东西不是来替代人的,是来帮人把那些重复的、没营养的杂活干掉的。原来运维工程师80%的时间都在处理重复告警、翻几百行日志、算每个服务器的资源使用率,这些机械性的活丢给AI,人才能腾出手去做架构优化、容量规划这些真正有长期价值的事。
那个零售客户的项目现在跑了快一年,原来每天要排两个夜班的运维团队,现在只需要留一个人备岗,遇到真的需要人工介入的告警再打电话。大家的月加班时长少了一半,没人再抵触这套系统,甚至有人主动提建议,要把监控里的哪些新指标喂给模型,让它的识别准确率再提一点。
其实AIOps从来不是什么需要顶礼膜拜的黑科技。它就是个能帮人省力气的工具。你搞清楚它的能力边界,从最痛的小场景开始慢慢迭代,它真的能帮运维团队少熬很多没必要的夜。要是一上来就抱着”上了系统就能躺平”的心态,最后大概率只会得到一堆没人点开的仪表盘,和一笔打了水漂的预算。