周五下午三点半,CI又红了。总覆盖率卡在67.3%,离部门定的80%红线还差一大截。项目经理在群里艾特人,声音隔着屏幕都能感到那种熟悉的窒息感。
你点开报告,看着满屏红色的未覆盖分支——全是if-else里的异常处理,还有几个switch的default。补吗?补完线上照样炸。
这就是单元测试覆盖率提升方法最尴尬的地方。数字上去了,心里反而更虚。
那个漂亮的覆盖率数字到底骗了谁
说实话,我见过太多团队把覆盖率当KPI来搞。月底冲指标,一个下午写两百个断言。这种测试有个特征:只测 happy path。输入正常,输出正常,断言 assertEquals(1,1)。这种写法覆盖率能飙到90%以上,但你永远测不到一个参数是 null 会怎样,一个下游服务超时了代码会不会崩。
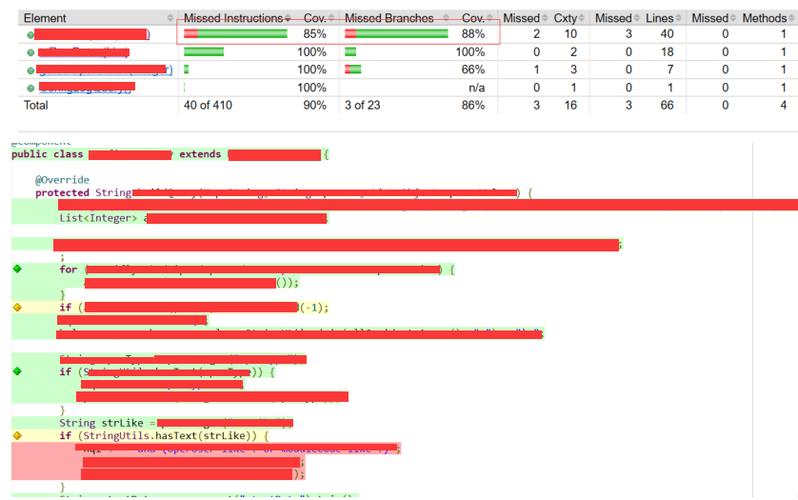
覆盖率分好几种口径。行覆盖、分支覆盖、路径覆盖、条件覆盖。行覆盖最水,一个if语句只要执行了if那一行就算覆盖。分支覆盖稍微严一点,它要求每个判断的真和假都走到。真正有参考价值的是分支覆盖和组合覆盖,但那俩数字通常很难看。
有个同事做过实验:某个核心服务行覆盖率93%,分支覆盖率只有54%。中间那39%的差距,全是异常分支和边界条件。后来线上出了一次故障,恰好就落在那个没被覆盖的catch块里——日志写错了,把一条重要告警吞了。
别急着搞大水漫灌先找出那几行值钱的代码
提升覆盖率这件事,最蠢的做法是给整个代码库定一个统一的数字目标。业务代码和工具代码、核心链路和边缘逻辑,它们的风险完全不一样。
我的做法是先给模块分档。支付、订单、库存、权限校验,这些属于第一档,目标定到80%以上的分支覆盖。内部管理后台的CRUD、一次性的数据迁移脚本,第二档,能测就测,不设硬门槛。第三档是自动生成的DTO和配置类,直接过滤掉不算。
具体怎么过滤?JaCoCo有exclude标签,Gradle或Maven里写几行配置就能把自动生成的类排掉。SonarQube也有对应的exclusion rules。这个动作本身不提升任何质量,但它能让你的覆盖率报告变得可信。一个掺了30%水分数据的报表,没人会认真看。
还有一条容易被忽略的:增量覆盖率。全量覆盖率是历史包袱,增量覆盖率才是当下行为的度量。我们在CI里加了个卡口,每个MR合并前,它改动的那些行必须被新写的测试覆盖。不要求80%,只要求改动部分有测试。这样一来,老代码不用动,新代码不许裸奔。
几种真能跑起来的土办法
说几个我自己试过、觉得有效的招。
结对写测试。不是结对编程,是专门找个人一起坐下来写测试。一个人写断言,一个人负责想输入。你会发现,当有人专门负责“攻击”你的代码时,那些边界值、空集合、超长字符串、并发重入的场景,哗哗地就冒出来。比自己一个人对着代码想快得多。
把flaky测试当生产故障处理。测试不稳定,跑十次挂两次,很多人选择rerun或者skip。这是个恶性循环。一旦团队习惯rerun,所有测试的可信度都会下降。我们定过一条规矩:任何一个测试连续三天出现不稳定,要么修,要么删。没有第三个选项。修的过程通常能看到并发问题或者测试间的状态污染,这些本身就是bug。
用变异测试找盲区。这个稍微进阶一点。Pitest这类工具会把你的生产代码做小改动——比如把>改成>=,把+改成-——然后跑你的测试。如果测试还是全绿,说明这个位置的断言是无效的。变异测试不能当日常指标用,跑得慢,但它特别适合在重构之后抽查一遍。我们做过一次,某个工具类的 kill rate 只有38%,那说明之前的测试全是摆设。
最后说点现实的
覆盖率提升没有银弹。它是个长期的、带着点笨拙的功夫活。你想让数字好看,一周就能做到。你想让测试真正在半夜拦住一个bug,那得花几个月把习惯养起来。
我现在的做法是:不盯总覆盖率,盯核心模块的分支覆盖率;不要求全员写完美测试,要求每个MR的改动有测试;每周花半小时看看那些红色的区域是不是有真问题。
就这样。工具是死的,人是活的。别让覆盖率变成又一个表演型指标就行。