上周跟一个在制造业做数字化的朋友吃饭,他说上周三凌晨三点爬起来改生产环境的数据库连接池参数,改完没十分钟,整个MES系统直接连不上产线的扫码枪,停线四十分钟,损失小几十万。为啥?他改的参数只在测试环境验证过,根本没同步到统一的配置库,之前的备份版本也没留,翻了半天才找到上周的配置快照,恢复完天快亮了。
这事说起来简单,本质上就是没把配置管理当回事。
没人天生愿意做配置管理
很多人刚接触运维或者DevOps工作的时候,觉得配置管理就是对着文档改改参数,点个保存,甚至觉得这是最没技术含量的活。谁都能上手。
真不是。之前我跑过一个互联网团队的现场,他们的配置文件散在每个开发的本地电脑里,有的存在共享文档里,还有的老员工走了之后,核心服务的参数连个半句话的说明都没有。上次要升个版本,三个人对着三个不同版本的application.yml文件吵了半小时,到底哪个是线上正在跑的版本。

麻烦在于,你以为的“改个参数”,背后牵的可能是一整条链路的权限、流量阈值、服务依赖。你把网关的超时时间从1秒改成3秒,没跟下游的缓存团队打招呼,赶上大流量峰值,缓存打满的瞬间,积压的请求直接把数据库冲垮。这种事我见过太多了。不是技术能力不行,是从一开始就没把配置管理当正经事做。
好的配置管理从来不是做满所有规则
很多团队一上来就想搞大而全的配置平台,什么环境隔离、版本追踪、审批流、自动回滚,恨不得所有配置改动都要走三五个审批节点,刚上线的时候大家都夸规范,用了三个月没人愿意提改动申请,绕开平台直接登服务器改参数,之前搭的平台直接成了摆设。
说白了,配置管理的核心不是把人管死,是让所有人在改配置的时候,不用猜“我改的这个参数会不会影响别人”,“改坏了能不能一分钟回退”。
我见过太多团队,花了几十万买商业配置中心,连最基础的功能都没用透。反而所有配置的变更必须有可追溯的修改人、修改时间、修改前后的差异、对应的验证记录,就这一条,比什么花里胡哨的功能都有用。很多团队连最基础的这一点都做不到,出了问题翻聊天记录,找半天才知道是上周谁改的什么参数,改的时候连个说明都没写。
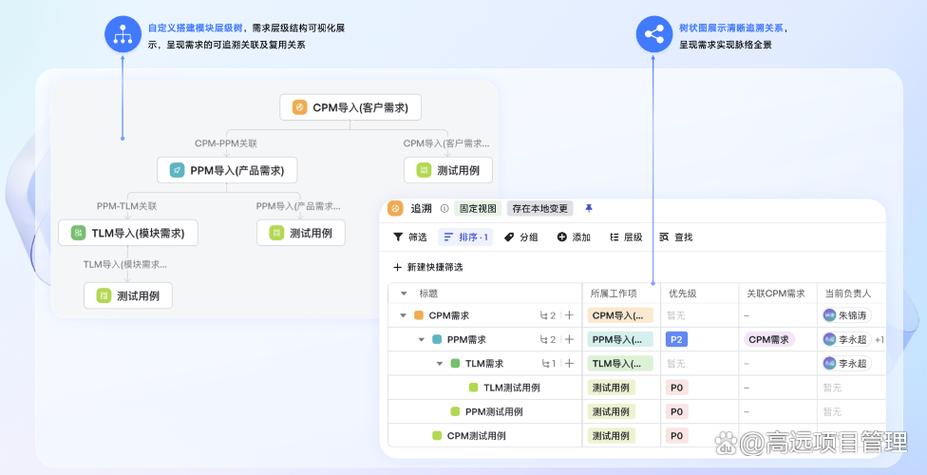
我见过最务实的小团队,根本没买昂贵的商业配置中心,就是把所有配置文件存在一个独立的Git仓库里,每次改配置必须提Merge Request,至少要一个同组的人Review过才能合入,合入之后自动同步到对应的环境,每次合并都留着完整的提交记录,改坏了直接revert上一个提交,五分钟就能恢复。就这么简单的流程,用了两年,没出过一次因为配置问题导致的长时间停线。
别等出了生产事故才补配置管理的课
很多人对配置管理的认知,都是被生产事故打出来的。之前有个做电商的团队,大促前一周改了订单服务的限流参数,没走任何配置记录,压测的时候没覆盖到这个参数的阈值,大促当天流量刚起来,订单直接被限掉三分之一,客服电话被打爆,找了两个小时才定位到是限流参数被改了。
说实话,这事没那么玄。你不用一开始就上多么复杂的平台,就从最基础的事做起:把散在各个地方的配置文件都收回来,统一存到一个所有人都能访问、有修改记录的地方;给每个配置项加个最简短的说明,告诉后来的人这个参数是管什么的,改的时候大概要注意什么;每次改完配置,留好可回退的版本。就这三件事,能解决80%的配置类故障。
很多团队总觉得,等业务跑顺了,团队规模大了,再慢慢补配置管理的流程。错的。你现在偷的懒,都会在某个凌晨三点的电话里找回来。你改的每一个没有记录的参数,都是埋在系统里的雷,不知道什么时候就炸。
真的。别不信。
上次那个停线四十分钟的制造业朋友,现在回到公司第一件事,就是把所有产线相关的配置全部梳理进Git仓库,每改一个参数必须两个人确认。他说现在再接到凌晨的告警电话,至少不用摸着黑翻聊天记录找版本了。
之前总有人问我,DevOps落地最该先做什么。不是搞CI/CD流水线,不是搞容器编排。先把配置管理的基础打牢。你连线上跑的系统参数是什么都搞不清楚,再花哨的自动化流程,跑出来的都是错的结果。