上周跟着运维团队值了次大夜。
凌晨两点的告警声比楼下早餐店的炸锅声还刺耳。后台CPU飘到98%,所有依赖下游的接口全卡成了蜗牛。查了半小时才发现,是某个外部合作方的批量同步任务没限频,直接把核心服务的连接池占满了。
很多团队刚上API网关的时候,总觉得把限流和熔断规则配上,就等于给系统上了保险。真不是。我见过太多团队,规则配的一塌糊涂,出了问题还怪网关的能力不行。
限流规则从来不是写死的阈值
很多人上来就拍脑袋定个全局QPS阈值,比如所有接口统一限1000QPS,配完就觉得万事大吉。麻烦在于,接口的实际承受能力根本不是一个数能概括的。同样是100QPS,一个是走本地缓存的商品详情查询接口,一个是要同步写三个数据库的订单提交接口,能扛的流量差着十倍都不止。
别拿通用模板套所有接口。之前见过有人把网关里的限流规则直接抄了开源项目的README,上线第一周就把正常的大促流量给拦了30%,整个运营团队对着后台的转化率曲线骂了一上午。

还有人搞不清令牌桶和漏桶的适用场景,给秒杀类的突发流量接口配了严格匀速的漏桶,前面攒的正常请求全被卡成了排队等待,用户点个按钮转三秒圈,骂的比谁都凶。更坑的是限流粒度的选择,上来就按IP做全局限流,完全忘了公司出口是同一个公网IP,全公司内部的员工测试请求全被拦,测试团队提的bug单能把工单系统刷爆。
这事没那么玄。你得先压测摸清楚每个接口的极限承载量,再按调用方、按接口路径拆细分规则。别一上来就全局一刀切。
熔断不是一断了之的开关
提到熔断,很多人的第一反应就是“下游挂了就断”。完全错。熔断的核心是给系统留喘气的窗口,不是把所有请求都直接拒在门外。
之前遇到过一次离谱的故障,下游服务只是因为临时发版,响应时间比平时慢了200ms,根本没到不可用的程度。结果团队配的熔断规则是连续5次超时就直接断10秒,刚好赶上业务高峰,10秒里所有正常请求全走了降级逻辑,直接返回“系统繁忙”,当天的用户投诉量直接涨了三倍。
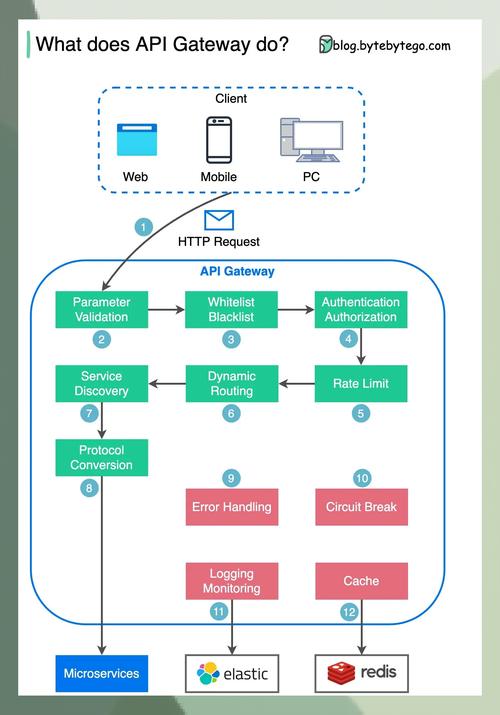
问题出在哪?熔断的触发阈值、半开状态的试探流量、恢复的时间窗口,全是要跟着实际调用情况一点点调的,根本没有放之四海而皆准的默认值。比如下游服务的正常响应时间是50ms,你把超时阈值设成1s,那等触发熔断的时候,网关队列里已经堆了成千上万的请求,光处理这些排队的请求就要花好几分钟。还有半开状态的试探流量,就放1个请求?万一这个请求刚好赶上下游服务的Full GC,直接又触发熔断,整个服务就陷在断了又开、开了又断的死循环里。
断的是有问题的调用。不是断用户的使用体验。很多人配熔断的时候根本不看降级返回的内容,熔断触发了直接返回500错误码,前端拿到这个错直接白屏,那还不如不熔断。
配置完别扔在那就不管了
我见过太多团队,限流和熔断的规则是项目上线那天配的,之后就再也没人动过。系统都迭代了大半年,规则还是最开始那套。
系统的承载能力是会变的。上个月你给服务加了两台机器,原来的限流阈值还是按单台机器的承载量算的,实际能扛的流量涨了一倍,你还卡着原来的阈值,平白浪费了资源。调用方的行为也是会变的,之前对接的合作方是每10分钟同步一次数据,后来他们改了同步逻辑变成每1分钟一次,你原来的限流规则没跟上,分分钟就能把你的服务打穿。
还有个所有人都踩过的小坑:配规则的时候把内部的健康检查接口也给限流了。结果网关自己的健康检查请求被拦,注册中心直接把健康检查失败的实例踢出去,集群规模越踢越小,最后整个服务直接挂掉。这种故障我蹲点的时候见过三次,每次复盘都觉得离谱,但次次都有人犯。
配置不是一劳永逸的事。是跟着系统一起长的。每次大版本上线之前,把所有的限流、熔断规则过一遍,跟最新的压测结果对一对。把被限流、被熔断的请求日志单独打出来,别跟普通访问日志混在一起,不然出了问题根本查不到是哪条规则拦的请求。
上次那个半夜告警的事,最后调整了啥?把原来全局的1000QPS限流规则拆成了按调用方维度的细分额度,给外部合作方单独开了200QPS的独立配额,把原来2s的熔断超时阈值调到了300ms,半开状态放5个请求做试探。之后再没出过同类的告警。
说白了,API网关限流与熔断配置从来不是什么高大上的架构设计,就是你蹲在机房里,对着一次次的告警、一次次的报错,慢慢磨出来的东西。别信那些说配三个规则就能防住所有雪崩的鬼话。你踩的坑够多,规则自然就配的对了。