上周在南京某互联网公司的机房蹲了一下午。
运维团队的小伙子蹲在机柜边揉眼睛,说刚因为一个容器镜像的版本错配,把整个支付链路的灰度节点搞挂了40分钟。
这事没那么玄。
说白了,很多人对容器化的认知,还停留在“把应用和依赖打个包,扔到任何机器上都能跑”的宣传话术里。真到了一线机房里,那些没人提前说的麻烦,才是每个团队上容器化之前必须算清楚的账。
最先跳出来的不是效率是新的麻烦
之前用虚拟机的时候,慢是真慢,重是真重。
但至少稳。每个机器的配置是固定的,改个配置要走完整的变更流程,出了问题顺着日志一步步找,总能摸到线索。上了容器化之后,镜像仓库的版本管理成了新的雷区。开发同学本地跑的镜像和推到仓库的镜像差了个配置文件,没人盯着镜像的校验和,部署上去直接把之前跑了大半年的老服务搞崩。

很多团队刚上容器化的时候,总觉得之前的部署流程太笨,要写一堆shell脚本,要手动配环境变量,容器化一把就能解决所有问题。真上了才发现,原来那些看起来笨的流程,本质上是在给人为操作的失误兜底。之前手动部署的时候,你要在测试环境跑三轮,确认没问题了才敢往生产发。现在容器的镜像构建是流水线自动跑的,代码推上去五分钟镜像就打好了。要是流水线里的测试步骤偷个懒没跑全,错误的镜像直接就进生产了。
别不信。我见过一个团队,流水线里的单元测试步骤因为配置问题被注释了三个月,没人发现,直到一次镜像里带了个硬编码的测试密钥,差点把数据库的权限全漏出去。
算得过来的成本和算不过来的账
很多厂商卖容器化方案的时候,总爱算一笔明面上的账:之前虚拟机的资源利用率只有20%,上了容器能到60%,算下来一年能省多少服务器的钱。
这笔账算得没错。
但没人跟你提另外的隐形成本。你得专门养一个团队来维护k8s集群,之前运维团队几个人就能管几十台虚拟机,现在光集群的版本升级、网络插件的故障排查、存储卷的挂载异常,就能占掉一半的人力。
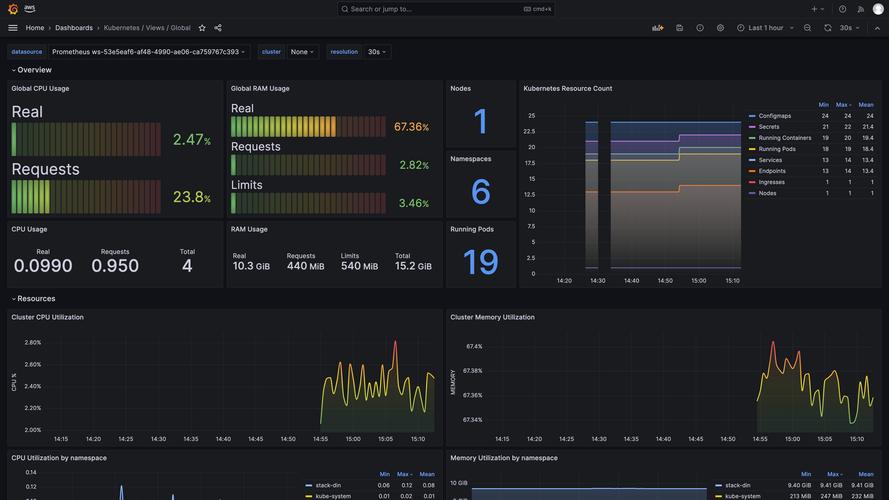
还有更隐蔽的代价。之前服务挂了,你能直接登到对应的虚拟机上,抓个包看个日志,翻两下就能找到问题。现在容器是动态调度的,可能你刚想登上去看,那个容器已经被调度到别的节点上了,之前的日志直接就跟着没了。很多团队刚上容器化的前半年,故障排查的平均时长是之前的两倍。不是技术不行,是整个系统的观测逻辑全变了。
我见过太多团队,为了赶技术热点,半年内把所有老服务全迁到容器上,最后天天救火,运维团队连吐槽的时间都没有。
值吗?
对有些团队来说,这点成本换回来的弹性伸缩能力,确实值。比如大促的时候,服务流量涨三倍,之前要提前两周备服务器,现在十分钟就能把对应的容器副本拉起来,流量退了就把资源收回来,这部分的收益是真的。但对那些一年到头流量都稳得像一潭死水的内部系统来说,花几十万搭一套容器集群,最后换回来的只是天天要修的插件故障,纯纯给自己找事。
容器化不是终点是新的起点
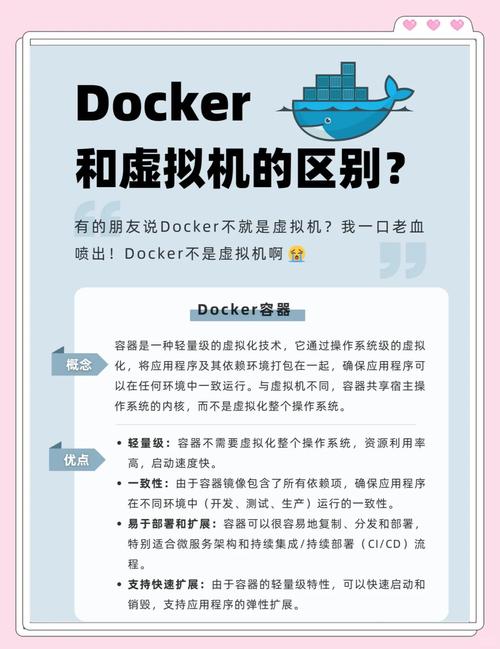
很多人觉得上了容器化,DevOps就算落地了。
根本不是。
容器化本质上只是把应用的运行环境标准化了而已。你还是得搞配置管理,还是得搞日志采集,还是得搞权限控制,还是得搞故障的快速恢复。之前这些事是散在各个虚拟机上的,现在全被容器编排平台聚合到一起了,反而对平台的稳定性要求更高了。
上次跟一个做了七年运维的老大哥聊天,他说现在最怕的不是应用出问题,是容器平台本身出问题。之前应用出问题,最多影响单个服务,现在平台的网络插件出个bug,整个集群里的所有服务都通不了。那种故障面的扩大,是之前用虚拟机的时候从来没遇到过的。
说白了,没有哪种技术是天生的万能解药。容器化确实解决了很多之前困扰团队很久的环境不一致问题,也把资源的利用率提上去了,但它从来不是你把镜像一打包就万事大吉的银弹。你得提前想清楚,自己团队的规模够不够撑起来这套体系,有没有专门的人来维护平台,能不能接受前半年的阵痛期。要是这些问题都没答案,光听着厂商说“上了容器就能降本增效”就一股脑迁上去,最后大概率要踩一肚子坑。