凌晨两点,手机炸了。不是电话,是告警群。两百多条消息,红点密密麻麻,像蚂蚁搬家。值班的小王盯着屏幕,手在抖——他根本不知道哪个是根因。大促刚过,订单量还在涨,但支付成功率掉了三个百分点。老板在群里问:多久能恢复?没人敢回。
这不是段子。很多团队上完K8s,搞了Prometheus、ELK、Jaeger,以为可观测性就齐活了。结果呢?工具越堆越多,故障定位时间反而更长。为什么?因为数据是散的。指标只看CPU内存,日志全是ERROR,链路追踪只覆盖了几个服务。出了事,你得在三个系统之间来回跳。跳着跳着,天就亮了。
可观测性不是三个工具的拼盘
先把概念捋清楚。监控是回答“系统是否正常”,基于已知的故障模式。比如磁盘满了、进程挂了。可观测性是回答“为什么系统不正常”,哪怕你从没见过这种故障。它靠的是从外部输出推断内部状态。三支柱——指标、日志、链路——只是手段,不是目的。
关键在关联。一个请求进来,你得能沿着TraceID串起网关的日志、服务的指标、数据库的慢查询。否则你有一万个数据点,也拼不出真相。我见过一个团队,每个服务都打了TraceID,但格式不统一,有的用UUID,有的用雪花算法。查一个请求,得写三套正则。这不是可观测性,这是给自己找活干。
还有个坑:把可观测性当运维的事。开发写完代码,丢给SRE,说“监控你们加一下”。SRE不知道业务逻辑,只能照着黄金指标配。结果告警阈值拍脑袋,白天没事,半夜乱叫。可观测性应该是开发者的责任。谁写的代码,谁定义埋点。谁更懂业务,谁定SLO。
从业务问题出发 而不是从工具出发
别一上来就选型。先问:我们要回答哪些问题?
比如电商场景。用户下单失败,可能的原因有:库存服务超时、支付网关拒单、风控规则误杀、消息队列积压。每个原因需要什么数据?库存超时——需要服务端的P99延迟、数据库连接池使用率、下游依赖的健康状态。支付拒单——需要支付网关的返回码分布、请求响应日志、渠道侧的同步状态。风控误杀——需要规则引擎的决策日志、用户行为序列。
把这些画成一张问题-数据映射图。然后你会发现,很多数据现在没采。比如数据库连接池,很多团队只监控了连接数,没监控等待时间。等待时间才是超时的直接原因。

再定采集策略。全量采集?成本扛不住。日志一天几个TB,链路采样率100%,存储费用能买辆车。我的建议:指标全采,日志分级,链路动态采样。错误日志和关键业务日志全留。信息日志按比例采。链路呢?正常流量采1%,但错误请求强制全采。这样既省钱,又不丢关键现场。
落地时最容易忽略的三件事
第一,标签规范。服务名、环境、集群、区域、版本,这些标签必须在所有数据源里对齐。不然你查一个服务,指标里叫“payment-service”,日志里叫“pay-svc”,链路里叫“payment”。别笑,这事太常见了。用OpenTelemetry的语义约定,或者自己定一套,强制推行。CI里加检查,不合规的埋点直接打回。
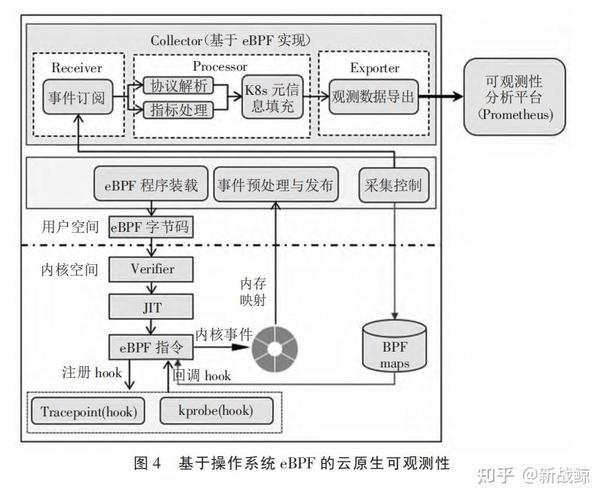
第二,采集管道要统一。别让每个服务自己往不同的后端发数据。用OpenTelemetry Collector做网关。好处是:一处采样、一处脱敏、一处路由。改配置不用重启应用。而且方便做数据富化——比如自动加上K8s的Pod标签。很多团队上了OTel SDK,但直接导出到后端,没走Collector。那等于买了净水器但不用滤芯。
第三,告警要降噪。可观测性做得好,告警应该变少,而不是变多。怎么做?基于SLO的告警。别盯着CPU 80%这种指标。盯着错误预算消耗速率。如果1小时消耗了10%的预算,才告警。平时有点抖动,正常。另外,告警要带上下文。点开告警,直接看到相关的日志和链路,而不是只给一个截图。
别指望一步到位 它是个演进过程
说实话,可观测性体系建设没有终点。业务在变,架构在变,故障模式也在变。今天你搞定了微服务,明天上了Service Mesh,后天又来了Serverless。每个阶段都有新的盲区。
但有几件事可以现在做:
- 组建一个虚拟团队,开发、SRE、运维都出人,两周碰一次,对齐埋点规范和痛点。
- 选一个核心业务链路,比如支付或登录,做端到端的可观测性改造。跑通一个,再复制。
- 把可观测性需求纳入开发流程。写代码时就想好:出问题了,我怎么查?需要打什么日志?加什么指标?这比事后补强得多。
- 定期做故障演练。故意注入延迟或错误,看看能不能在5分钟内定位。练多了,真出事才不慌。
最后说个情绪化的感受:我见过太多团队,大屏做得漂漂亮亮,各种曲线五颜六色。但一问“昨天那个超时到底为什么”,没人答得上来。可观测性不是给领导看的,是给凌晨三点被叫醒的工程师用的。它应该让你少加点班,而不是多写几份复盘报告。
别把可观测性搞成面子工程。从一次真实的告警开始,从一条TraceID开始。慢慢来,比较快。