缓存不是数据库的复印件
分布式缓存一致性保障,很多人第一反应是“失效”。缓存失效只是表象。更麻烦的是读写路径上的顺序和可见性。数据库里已经是新值,缓存里还是旧值。用户看到旧库存、旧头像、旧权限。线上最怕这种。
说白了,缓存不是数据库的复印件。它是一份可以被短暂容忍错误的副本。容忍多久,取决于业务。商品详情页可以旧几秒。优惠券余额不行。库存扣减更不行。所以先别急着找“最强方案”。先问一句:这份数据到底能脏多久。
强一致,代价高。最终一致,窗口要可控。中间还有读己之写、单调读这些级别。业务常常嘴上要强一致,实际只想不出错。对账能兜住,就能放宽。对吧?
Cache Aside 的顺序陷阱
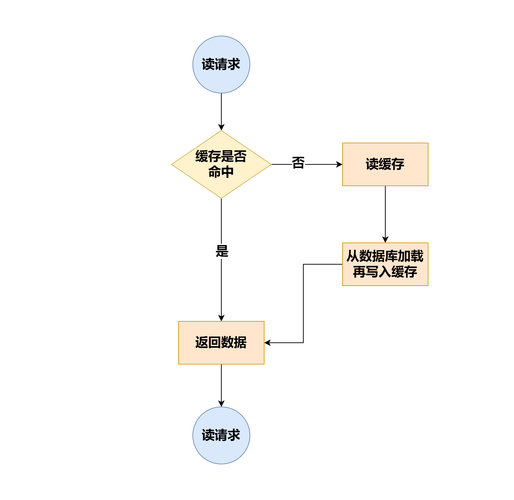
常见做法:读时先查缓存,没有就查库,再回填。写时更新数据库,再删缓存。这叫 Cache Aside。顺序看起来简单。坑在并发。
线程 A 读,缓存没命中。它去查库,拿到旧值。线程 B 此时写库,新值提交,然后删缓存。线程 A 回来,把旧值塞进缓存。缓存里就长期是旧值。后面所有读都命中脏数据。可怕的是,没人报错。
怎么办?有人加分布式锁。读和写都锁同一个 key。能解决,但吞吐掉得厉害。热点 key 更惨。有人用延迟双删。先删缓存,再写库,睡一会儿,再删一次。延迟多久?拍脑袋不行。主从同步延迟、业务读耗时、GC 停顿,都会影响。延迟短了删不干净,长了只是缓解。
先更新数据库再删缓存,是常见起点,不是终点。删缓存失败要重试。重试要幂等。更稳一点,订阅数据库 binlog,把变更投到消息队列,让消费者删缓存。这样业务代码和缓存清理解耦。但别以为上了 MQ 就万事大吉。消息会重复,也会乱序。
版本号能挡住旧值回写

一个更细的做法:缓存值里带版本号。数据库每次更新,版本递增。回填缓存时,用 Lua 脚本比较。只有新版本才能覆盖旧版本。旧值回写?直接丢弃。这个思路不新鲜,但好用。
版本号从哪来?可以是更新时间戳,也可以是递增序列。时间戳要小心时钟回拨。序列号要全局唯一。单机自增不够。可以用数据库版本字段、Redis INCR、雪花算法。选哪个,看现有链路。麻烦在于,所有写路径都得带上版本。漏一条,前功尽弃。
消息队列也能配合版本号。同一个 key 的变更,尽量投到同一分区,保证顺序。消费者拿到消息,先比较版本,再决定删缓存还是更新缓存。重复消息?用唯一 ID 去重。乱序消息?旧版本直接忽略。这样,分布式缓存一致性保障才从“尽量”变成“可验证”。
本地缓存别当自己人

多级缓存里,本地缓存最容易被忽略。JVM 内的 Caffeine,速度极快。但每个实例各存一份。Redis 更新了,本地缓存不知道。用户请求打到旧实例,就看到旧数据。刷新时间可能长达几分钟。
通知机制?Redis Pub/Sub 可以广播失效事件。但 Pub/Sub 不保证送达。实例重启、网络抖动,消息就丢了。改成消息队列广播,可靠性高些。可还是有延迟。最实用的办法:本地缓存只放能容忍旧的数据,并且 TTL 设短。比如配置项、字典表、非关键商品属性。余额、库存别放本地。除非你愿意做复杂的一致性协议。
还有热点 key。同一个 key 被疯狂读,缓存一失效,请求全打到数据库。这叫击穿。击穿和一致性是两件事,但经常一起出现。互斥重建、逻辑过期、永不过期加后台刷新,都能用。逻辑过期本质是接受短暂旧值,换数据库平安。值不值?看业务。
监控和修复才是底线

再好的方案也会出错。网络分区、发布回滚、代码 bug,都能制造脏缓存。所以监控不能少。抽样比对数据库和缓存,定时跑。发现不一致,告警。别等用户投诉。
修复也要小心。直接删缓存,可能引发雪崩。直接写新值,可能覆盖并发更新。最好走版本号,或者把修复消息投到同一套变更链路。让修复和正常更新遵守同一规则。回滚时,先降级读数据库,再逐步恢复缓存。别一键清空,那是灾难。
分布式缓存一致性保障,说到底是取舍。没有免费的一致性。强一致要牺牲可用性和延迟。最终一致要接受窗口和补偿。中间件不会替你决定业务能忍多久。代码里的每个顺序、每次重试、每个 TTL,都是在回答这个问题。答错了,缓存就从加速器变成事故源。答对了,它才安静地待在那里,像什么都没发生。