凌晨两点,运营在群里丢了一张截图。同一个账号,刷新前看到新结算页,刷新后又回旧版。研发说灰度比例设了百分之五。问题不在百分之五,在“每请求随机”这四个字。
灰度发布里的流量切分策略,很多时候被简化成一个滑动条。其实滑动条只决定切多少。真正难的是切谁、切多久、切错了怎么收。说实话,这活比写业务代码更考验边界感。
百分比不是策略它只是策略的结果
把百分之五的流量打到新版本,这句话听起来很明确。但百分之五按什么分?按请求、按用户、按设备、按租户,还是按地域?差别很大。
面向C端的功能,最好先按稳定身份切。比如用户ID、账号ID、设备ID。用哈希取模或者一致性哈希,让同一个用户在灰度周期里固定落在旧版或新版。否则用户会像抽盲盒。客服电话就来了。
同一个用户在同一段灰度期里看到同一个版本,这是体验底线。推荐、搜索排序这类请求级效果,可以接受随机切分,因为每次请求本来就是独立的。但交易、订单、支付、账户设置,别这么干。
还有白名单。内部员工、种子用户、大客户,这些流量适合第一批。别一上来就对外随机。先让能骂你的人骂,改完再放出去。这个顺序反了,事故概率会高很多。
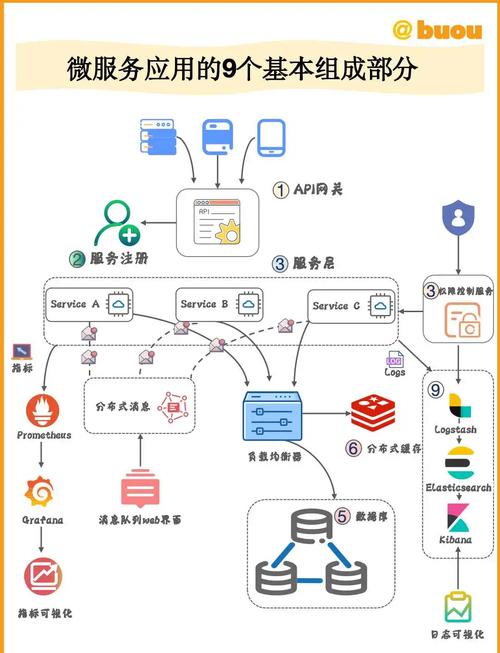
网关层切流只是入口真正麻烦在后头
很多团队在Nginx或者网关加个规则,按header或者cookie分流。入口看起来没问题。请求进了内网,调用链一长,灰度标记就丢了。A服务知道自己是灰度,B服务不知道,C服务读缓存更不知道。
结果就是新旧逻辑混跑。更麻烦的是异步链路。消息队列、定时任务、事件总线,这些流量没有HTTP header。你不把标记塞进消息属性,消费者只能靠猜。
比较稳的做法是流量染色。入口给请求打一个标签,比如x-gray-tag,然后通过线程上下文、RPC上下文、消息头一路透传。服务网格能省掉一些侵入,但业务代码该读上下文还得读。别指望基础设施解决所有问题。
数据库和缓存也要提前想。新版本要加字段,旧版本不认识。双写、影子表、兼容读取,这些不是灰度当天才做的。否则切流到一半,发现旧代码解析不了新数据,回滚都回不干净。
回滚不是把流量百分比调回零就完事。数据格式、缓存键、消息结构,都可能已经变了。灰度前得问一句:退回去,旧版本还能不能吃新数据?

给团队的一份灰度切分检查清单

下面这些不是标准答案,更像踩坑之后留下来的便签。按自己业务裁剪。
1 统一身份标识。用户、设备、租户,至少有一个能在全链路稳定传递。别这个服务用session,那个服务用uid。
2 规则集中管理。分流规则别散落在Nginx、代码、配置中心三个地方。出问题时没人知道以谁为准。
3 开关默认关闭。新逻辑上线,灰度开关默认关。需要开的时候手动开,别默认开。
4 监控按版本拆维度。总错误率没涨,不代表灰度版本没炸。要看灰度标签下的错误率、延迟、业务转化。
5 流量阶梯别跳。内部员工、白名单、百分之一、百分之五、百分之二十、全量。每一步停多久,看业务周期。支付类至少跨一个结算日。
6 设退出条件。错误率超过多少、客诉超过多少、核心指标跌多少,自动或手动回滚。写在值班手册里,别靠临时拍脑袋。
7 限流熔断别只护着旧版本。新版本资源占用可能完全不同。切流之前压测,切流之后盯着容量。
8 保留现场。灰度出问题,日志、trace、指标要能按灰度标签捞出来。没有观测,回滚也只是赌运气。
说到底,灰度发布中的流量切分策略不是越复杂越好。小团队一个用户ID哈希加白名单,能解决八成问题。大团队有全链路染色、服务网格、规则中心,也得防着规则腐化。
别把灰度当护身符。切得细,不如切得稳。半夜能睡着,比多省几台机器值。