API网关限流与熔断配置别等崩了再改
2026-11-15 12:38:40
作者:
fawen
限流配错了比不配更可怕
限流算法就那么几种。令牌桶、漏桶、滑动窗口。很多人直接选令牌桶,因为支持突发。但突发多少?桶容量多大?填充速率多少?这些数字得从实际流量来。我见过一个团队,把桶容量设成1000,填充速率100/s。结果上游一个批量请求过来,瞬间打满桶,后面的全被限。他们以为限流是保护,结果变成误杀。
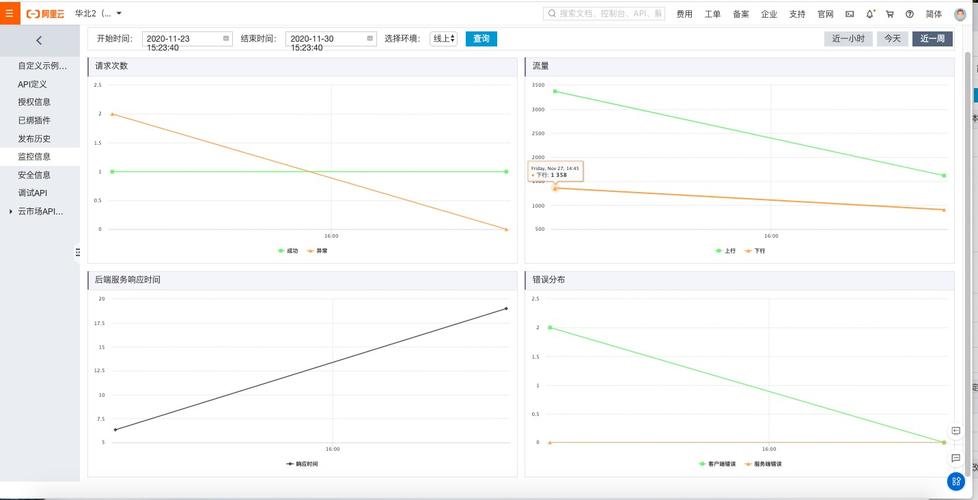 API网关限流熔断配置监控面板
更麻烦的是,限流规则的位置。在网关层做限流,粒度可以到路由、到API、到用户。但如果你在网关限了,后端服务自己也限,两边阈值不一致,就会出现一边限一边放。流量像打地鼠。说白了,你得有个全局视图。谁负责哪一层,别重复。
还有,限流返回的状态码。默认429,但有些客户端不认,直接当失败重试。重试风暴反向打网关。这时候你得考虑返回一个友好的降级响应,或者让客户端退避。这些细节,配置文档里通常不写。
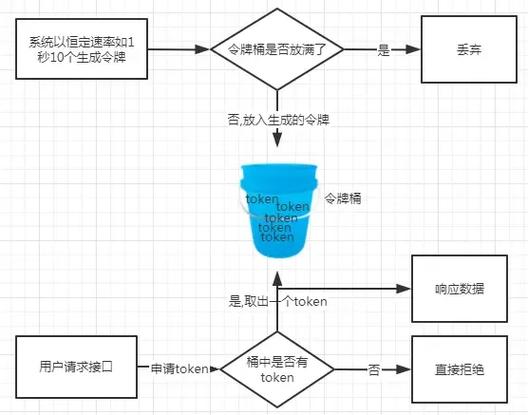 令牌桶算法限流配置参数示意图
熔断的恢复策略才是真考验
熔断器三个状态:关闭、打开、半开。关闭时正常放行,打开时直接拒绝,半开时放少量请求试探。问题往往出在半开。你设的失败率阈值是50%,最小请求数10。打开后,等5秒进入半开。半开时放1个请求。如果这个请求刚好因为网络抖动失败,熔断器立刻回到打开。再等5秒,再放1个。如果下游还没恢复,那就一直循环。这叫“熔断器抖动”。下游服务其实在慢慢恢复,但你的探测请求太稀疏,永远探不到。
怎么破?半开状态允许的请求数不能太少。经典做法是允许一定并发,比如5个,然后根据这5个的结果决定。但不同网关实现不一样。有些网关只支持固定数量,有些支持按比例。你得看文档,还得压测。另外,超时时间设置也很关键。熔断的超时通常比普通请求超时短,但也不能太短。太短了,正常慢请求也被熔断。太长了,熔断反应迟钝。
还有一个隐形坑:熔断和重试混用。重试本身会放大流量,如果熔断器没开,重试可能压垮下游。如果熔断器开了,重试又打在半开状态,干扰探测。所以,重试策略得和熔断配合。一般建议重试只针对幂等请求,且限制次数。
配置之外的那些事
 配置之外的那些事
限流和熔断的配置,光看文档不够。你得有监控。没有监控,你根本不知道限流触发了多少次,熔断器状态变了没有。很多网关提供了Dashboard,但指标粒度粗。比如只告诉你总限流次数,不告诉你哪个API被限了。这时候得自己埋点,或者用日志分析。
另外,动态配置很重要。业务流量是变化的,大促前调阈值,大促后调回来。如果每次都要重启网关,那运维得疯。所以选网关时,看它支不支持热更新。Nginx Plus、Spring Cloud Gateway、Kong这些都有方案。但热更新也可能有坑,比如配置推送延迟,或者部分节点没生效。你得有个兜底。
最后,别忽略压测。限流和熔断的阈值不是拍脑袋定的。压测时,模拟真实流量模型,观察网关和后端的表现。找出瓶颈,再定阈值。压测环境尽量和生产一致,否则数字没意义。我见过一个团队,压测时用4核8G,生产是8核16G,结果阈值定低了,大促时白白限流。
所以,API网关限流与熔断配置,不是抄个数字就完事。它需要你理解流量、理解故障、理解恢复。别等崩了再改。平时多演练,多观察。凌晨三点的电话,能少一个是一个。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
API网关限流与熔断配置别等崩了再改
文章链接:https://www.itcdj.com/news/835.html