周二下午三点。老张提了个PR,三十来行,改的是订单拆单逻辑。CI红了。
他愣了一下,本地跑得好好的。点开日志,挂了三个测试,全是别人写的。他盯着屏幕,第一反应不是“我改错了”,而是“这测试写得真烂”。说实话,这反应我也有过。但十有八九,问题真不在测试身上。
写不出测试 往往是代码先动的手
见过一个方法,两百多行,中间 new 了五个对象,调了三个静态工具类,还顺手查了一次库、发了一次消息。你让谁来给它写单元测试?写不了。不是水平问题,是结构不给你机会。
所以我一直觉得,单元测试的第一价值不是抓 bug,是当设计探针。你坐下来写测试,写了两行发现得先 mock 一个数据库、再 mock 一个 HTTP 客户端、还得给当前时间打桩——这时候你就该停手了。这说明这个类背了太多不属于它的活。
把依赖从方法体里挪到构造函数里,把隐式的全局状态改成显式传参,把“取时间”这种动作换成注入一个 Clock。做完这几步,你会发现测试突然就好写了。就这么简单,也就这么难。

顺便提一句,静态方法是个重灾区。它调用方便,代价是你永远没法替换它。真要用,就让它保持纯粹:输入确定,输出确定,不碰 IO,不碰时间。
Mock 用多了 测试就变成了自说自话
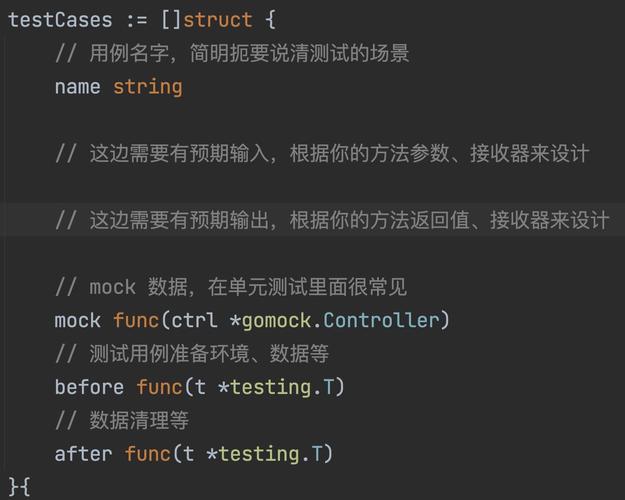
见过更离谱的。一个测试里 mock 了八样东西,最后的断言是——verify 某个 mock 被调用了两次。
这测的是啥?测的是你 mock 打得对不对。业务逻辑改了它不红,mock 挪个位置它倒红了。这种测试不是资产,是负债。它唯一的作用是让你在重构的时候多花两个小时。
边界在哪?我的土办法是分两类:
跨进程的、慢的、不确定的——数据库、缓存、消息队列、外部接口、当前时间、随机数——全部隔离掉。这个没得商量。
你自己项目里的纯逻辑类——直接 new,别 mock。很多人图省事把 service 也 mock 了,结果测试绕过了真正想验证的那段逻辑,跑得飞快,绿得发光,什么都没测。
还有个细节。时间相关的代码,别用 sleep 去等。用注入的 Clock 或者把“现在”当参数传进来。测试跑 8 秒和跑 80 毫秒,团队的忍耐度完全不一样。慢测试最后都会被 skip 掉,这是人性。
覆盖率那个数字 别太当真
80% 的行覆盖率,听起来挺唬人。翻开一看,一半是 getter、setter 和 DTO 撑起来的。还有那种 assertTrue(true) 凑数,你懂的。
更有意思的是分支。一个 if-else,只跑了 true 那条路,行覆盖率照样漂亮。行覆盖率骗人,分支覆盖率稍微好点,变异测试才接近真相。变异测试说白了就是往你代码里塞小 bug——把 > 改成 >=,把返回值取反——然后看测试抓不抓得住。抓不住,说明那行测试等于没写。
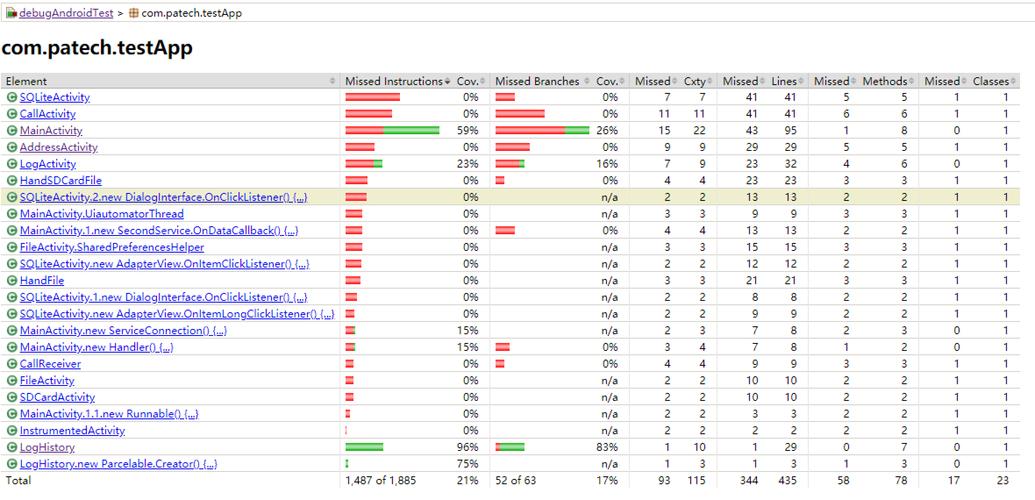
不过话说回来,覆盖率别拿来当 KPI。一旦跟绩效挂钩,你得到的只会是一堆为了绿而绿的测试。让工程师自己判断哪块代码值得测,比定一个 90% 的指标有用得多。
几条能落地的做法
清单放这儿,我自己在用的:
1. 新写的核心逻辑,测试跟代码一起提。老代码别硬补,等哪天真要改它了,顺手补一段。硬补出来的测试,多半也没人看懂。
2. 一个测试验证一个行为,但可以有多条断言。别教条到一个断言写一个方法,那样测试文件比业务代码还长。
3. 命名说人话。should_throw_when_amount_is_negative 这种就挺好,比 test1 强一万倍。失败的时候,日志里那一行名字就是你的第一条线索。
4. 测试之间不许有顺序依赖。每个测试自己准备数据,自己清理。共用状态的测试,跑单个过、跑全量挂,这种事故太常见了。
5. CI 挂了的测试,当场修,或者当场删。skip 掉当没看见,三个月后整个目录没人敢碰。技术债都是这么长出来的。
6. 测试代码也是代码。它会被读、被改、被继承。写得脏兮兮的测试,比没有测试更劝退新人。
有一点得说清楚:这套做法对业务逻辑密度高的模块特别值,对那种纯粹的胶水层、CRUD 直传的代码,收益就一般。别为了统一而统一。有的团队连 controller 都要写测试,最后写出一堆重复的样板,图啥呢。
最后还是那三行代码
老张那天下午把那个测试修好了。修的过程中他发现,拆单逻辑里确实漏了一个边界——金额正好等于免运费门槛的时候,分支走错了。
他后来在群里发了句:早知道先看测试的。
你看,单元测试不是让你证明自己写对了。它是让你在某天下午三点,被一个陌生人的测试拦住,然后发现自己错在哪。