凌晨两点十七分,手机在枕头边震。运维群里一张截图:订单库 CPU 打满,接口 P99 从 80 毫秒飙到 4.2 秒。群里没人说话,都在等我。
这种事我干过太多次了。数据库慢查询这活儿,难的不是技术,是在慌的时候还能按顺序做事。
先看现象,别一上来就加索引
很多人的第一反应是——加索引。我劝你先忍住。索引不是止痛药,乱加会反过来拖慢写入,A 表加完 B 表卡,最后整条链路更烂。
先干三件事。
看当前正在跑的会话。MySQL 里就是 show processlist,或者查 information_schema.innodb_trx 盯长事务。有一条 SQL 跑了 200 秒还在 Sending data?那就是它。
再看锁。慢查询有时候不是慢,是等在锁上。你 EXPLAIN 一百遍也看不出问题,因为执行计划没毛病,是别人占着行锁不撒手。

最后看大盘。QPS 有没有突增?连接数是不是被打满了?是不是有人偷偷上了个定时任务?我遇到过最离谱的一次,是新来的同学写了个 for 循环查数据库,一万次单条查询——
对,就那种。删掉,世界清净了。
慢查询日志,得先确认它真的开着

这话听着像废话,但真的是这样。很多线上库的 slow_query_log 压根是关的,或者 long_query_time 设成了 10 秒。10 秒什么概念?用户早跑光了,你日志里一条没有,还以为天下太平。
我的习惯是线上设 0.5 到 1 秒,配合 pt-query-digest 每天跑一遍。别小看这个数字,它能让你从“事后救火”变成“提前知道谁在挖坑”。
不过话说回来,日志量会涨。磁盘和采集链路要提前算好,不然慢查询没治住,先把日志盘写满了,那就成了另一个故事。
EXPLAIN 里真正该盯的字段
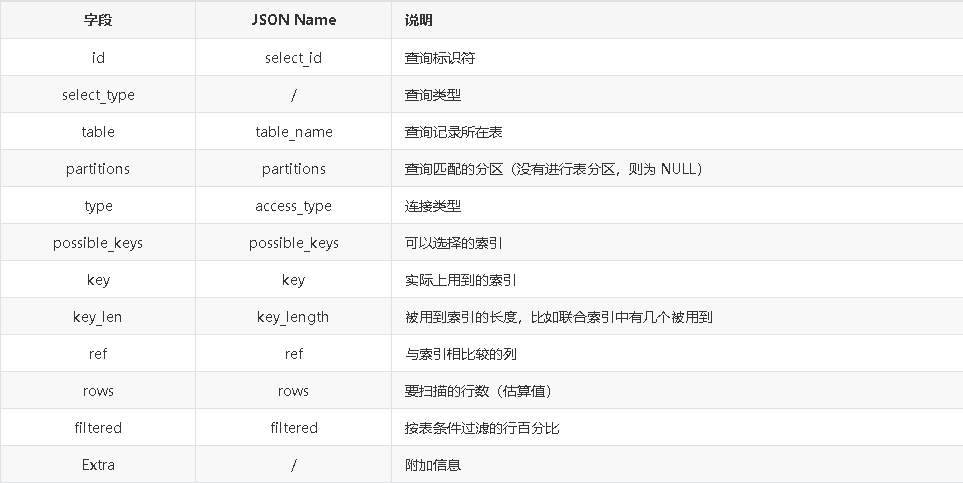
EXPLAIN 谁都会敲,但很多人只盯着 type 是不是 ALL。其实更该看这几样:
rows——预估扫描多少行。如果预估几百万,基本可以判死刑了。
filtered——过滤比例。这个值很低,说明索引挑出来的数据大部分被丢掉了,白干。
key 和 possible_keys 对不上,意思是明明有索引却没用上。常见原因是列上做了函数运算、隐式类型转换,或者最左前缀断了。比如手机号是 varchar,你拿个数字去查,MySQL 会偷偷转换,索引直接失效。
还有个坑:回表。二级索引找到主键,再去聚簇索引捞整行。数据量小没事,一旦回表几万次,IO 就炸了。这种时候要么改覆盖索引,要么狠一点,直接上联合索引把字段兜住。
但联合索引不是越长越好,字段顺序错了照样白搭。顺序这事没有标准答案,得看你的 where 和 order by 谁先谁后,老老实实拿真实 SQL 去试,别拍脑袋。
优化完了,才是最难的部分
技术方案改完,其实只做了一半。剩下的一半在人和流程上。
我见过太多团队,DBA 把慢 SQL 优化得漂漂亮亮,两周后业务迭代,问题又回来了。为什么?因为没人拦着新代码往里塞烂 SQL。
能落地的做法大概这么几条。
一是上线卡口。CI 里跑一遍 SQL 审核,扫增量 DDL 和 DML,全表扫描、缺索引、select 星号直接打回。别指望人自觉,工具才可靠。
二是慢查询的归属权。每条慢 SQL 都要能落到人头上,谁的表谁负责。没有归属,就会变成大家一起看、没人真管。
三是定期复盘。不是开会念报表,是把 top 10 慢查询拎出来,一条条说清楚为什么慢、怎么改、改完效果多少。一个月一次,够了。
四是给数据库留余地。读写分离、冷热分离、缓存兜底,这些不算银弹,但它们能让一次慢查询不至于直接变成事故。
最后说句实话。数据库慢查询这事,没有什么一劳永逸的招。它更像是个持续打扫的过程——你不扫,灰就在那儿堆着,哪天堆到临界点,报警就来了。
凌晨那次的结局?加了个联合索引,把那条 SQL 从 4.2 秒压到 30 毫秒。然后我关掉手机重新躺下,脑子里还在想那个 for 循环。