先别急着画大图。湖仓一体这四个字,很容易被讲成“湖也想要,仓也想要”。听着没错,做起来完全是另一回事。
我见过不少团队,PPT 上写着统一元数据、统一权限、统一 SQL,底下跑的还是 Hive 表加一堆临时导出。问为什么,回答很统一:稳。老链路虽然丑,但它不炸。
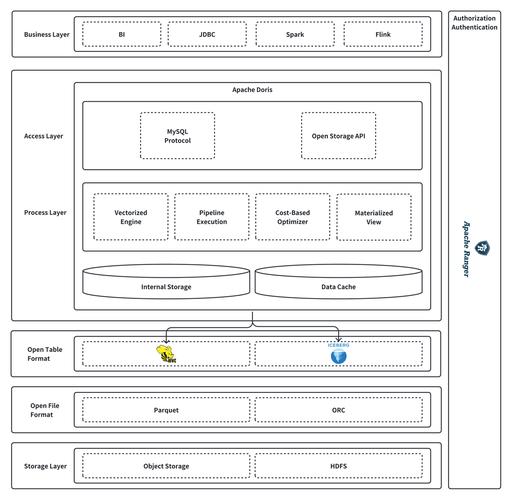
这事没那么玄。湖仓一体不是把数据湖和数据仓库缝在一起,它更像是在对象存储上重新盖一套仓的规矩。规矩的核心,是开放表格式。
麻烦不在存算分离,在表格式那一层
传统数仓把元数据、事务、统计信息都锁在数据库里。数据湖反过来,文件往对象存储一扔,谁都能读,但谁也说不清哪份最新。Hive Metastore 管分区,管不了 ACID 行级更新,更管不了并发写。于是就有了 Delta Lake、Iceberg、Hudi 这些表格式。
它们干的事,说白了,是在一堆 Parquet 文件上加一层事务日志和元数据。写入先写新文件,再提交元数据快照。读的时候按快照读,读到一半有人写,也不会看到半截数据。ACID 有了,时间旅行有了,schema 演进也顺了。加字段、删字段,不用重写全表。
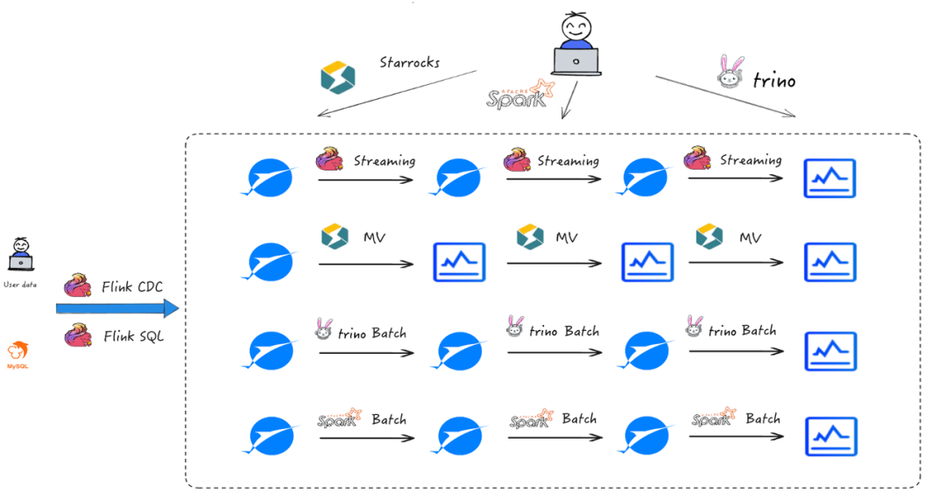
湖仓一体的关键不是查询引擎,而是表格式能不能被多个引擎共享。Spark 写进去,Trino 读,Flink 接着流式写,外面还有 Python 跑机器学习。如果每家都用自己的元数据,那就不是湖仓,是多个小仓库套同一个存储桶。
Iceberg 的元数据树挺值得看。catalog 指向 metadata file,metadata file 指向 manifest list,manifest list 再指向 manifest file,最后才到数据文件。层级多,换来的是快照隔离和文件级统计。查询规划时能跳过大量无关文件。对海量分区表来说,这个收益很实在。
但层级多也意味着元数据服务容易成瓶颈。每次提交都要写新 metadata,小文件一多,manifest 膨胀得比数据还快。有人把 Iceberg 当银弹,上线三个月后发现 catalog 响应慢,查询规划时间比扫数据还长。不是 Iceberg 不行,是没人做 compaction 和元数据清理。
实时写进来之后麻烦才真正开始
批处理时代,一天跑一次,小文件问题还能忍。Flink 一接进来,五分钟一次 checkpoint,甚至更短。每次提交都产生新文件。对象存储按请求计费,元数据服务按提交次数受累。业务方只看延迟,平台方盯着文件数,两边都很委屈。
这时湖仓一体要回答几个硬问题。多久 compaction 一次?谁来做?和写入任务抢资源怎么办?删除文件什么时候真正回收?快照保留多少天?这些问题没有标准答案,只能按查询模式调。读多写少,可以激进 compaction。写多读少,维护窗口就得错峰。麻烦在于,很多团队把维护任务当附属品,结果主链路被拖垮。
还有个容易忽略的点:权限。数据湖时代靠目录和文件 ACL,粗放但能用。湖仓一体要求表级、列级、行级权限,还要和 catalog、查询引擎、BI 工具对齐。不同引擎对同一张表的权限解释可能不一样。最后变成权限策略写三套,审计还是对不上。
再说成本。对象存储便宜,但请求不便宜。计算引擎弹性,但扫描量大了也贵。湖仓一体把存储和计算拆开,账单也跟着拆开。以前一个数仓团队扛总成本,现在存储、计算、元数据服务、调度、维护任务各算各的。没人统一看,很容易出现存储费用降了,计算费用翻倍,总账还涨了。
我听过一个不算复杂的例子。某团队把一批 Hive 表迁到 Iceberg,Trino 查询确实快了,但凌晨 compaction 任务把对象存储带宽占满,报表任务开始超时。后来把 compaction 拆成小批,限制并发,又加了元数据过期清理,才算稳住。没有戏剧性翻车,就是长期磨损。
别把湖仓一体做成新一轮烟囱
很多选型讨论一上来就比引擎。Spark、Flink、Trino、Doris、StarRocks,谁快谁慢。快当然重要,但湖仓一体的重点在共享。表格式共享,catalog 共享,权限模型共享,血缘和治理也得共享。否则查询是快了,数据还是各管各的。
开放表格式的好处是解耦。今天用 Spark,明天换 Trino,数据不用搬家。坏处是责任也解耦了。写坏了谁修?元数据膨胀谁清?权限不一致谁背?如果组织上没有平台团队兜底,湖仓一体很容易退化成“谁用谁维护”的松散联盟。最后每个业务线自己建小集群,烟囱又回来了。
湖仓一体不是一次迁移项目,它更像长期运营。表格式版本要升级,catalog 要扩容,compaction 策略要跟着业务变。上线只是开始。那些跑得稳的团队,通常不是选了最时髦的组合,而是把维护任务、成本归属、权限流程提前定清楚了。
真要动,先看几个不性感的问题
第一,现有 Hive 表有多少分区,多少小文件,多少历史快照需要保留。第二,并发写入场景到底有多少,Flink 作业的 checkpoint 间隔能不能调。第三,查询引擎是否都支持同一种表格式版本,catalog 用 HMS 还是 REST。第四,谁负责 compaction,预算从哪出。第五,出问题能不能回滚到旧快照。
这些问题不酷,但决定湖仓一体能不能活过半年。如果只是想解决 BI 查询慢,也许优化 Hive 分区和文件布局更直接。如果确实要流批一体、多引擎共享、开放格式,那湖仓一体值得做,但得按运营项目做。
说到底,湖仓一体不是把湖和仓焊在一起。它是在对象存储上重建一套可共享、可治理、可演进的表。技术选型只是开头。后面那些脏活累活,才是分水岭。