去年冬天,一个做风控的老哥拉着我喝茶。不是聊技术,是吐槽。
他那项目卡了三个月。银行想要医院的病例数据做联合建模,医院那边一句话:数据不出院,出了事谁担。两边都懂业务,也都有道理,就是谈不拢。最后有人提议——上隐私计算吧。
三个字扔出来,会议室反而安静了。因为没几个人真知道,那玩意儿到底能干嘛。
它能解决的,其实是一道很窄的门
先把话说明白。隐私计算核心就一件事:让各方在不交出原始数据的前提下,共同算出一个结果。
注意。是算出一个结果,不是拿到数据。
这个区别特别关键。太多人一上来就理解歪了,以为上了隐私计算,别人的数据就能随便用。不是这样的。你最后拿到手的,往往只是一段模型参数、一个统计值、或者一个打分区间。原始数据那扇门,还是关着的。
技术路线上大致三条。
多方安全计算,几个参与方各持一份数据,靠密码学协议协作计算,谁都看不到对方的输入。听着很美,代价是通信量巨大。
联邦学习,数据不动模型动。各方在本地训练,只往外传梯度或者参数更新。
可信执行环境,在硬件层开一个黑盒,数据进去能算,外面看不见。
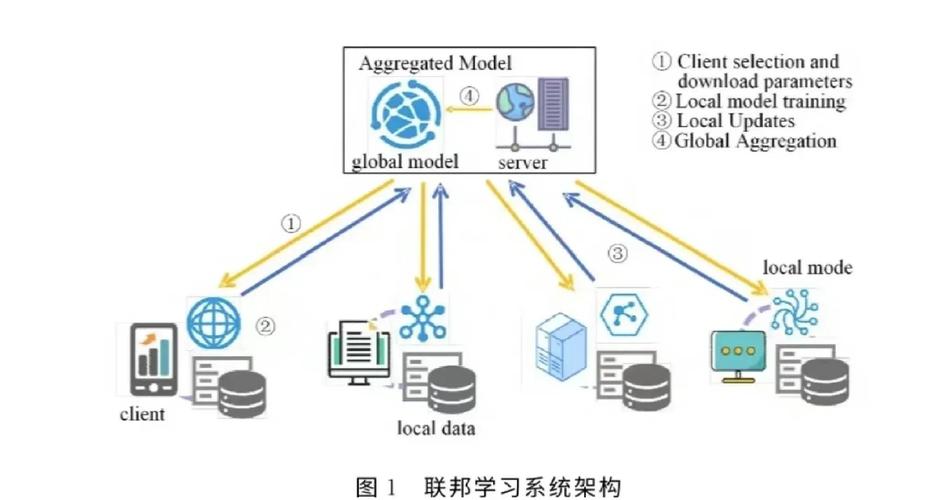
这三样不是替代关系。是扳手、螺丝刀和钳子。真要落地,经常是混着用的。
坑都在哪

先说联邦学习。它不是银弹。梯度里是带着隐私泄露风险的,2019年就有人演示过,从梯度里面能把原图反推出来。所以光有联邦学习不够,还得叠加差分隐私、接上安全聚合。少了这两样,等于窗户纸糊的。
然后是多方安全计算的性能。跨机构跑一次联合查询,通信开销能把人逼疯。小样本场景还能跑,样本量上到千万级?先别提上线,做一轮压测再说吧。我见过一个团队,压测跑了三天,最后发现瓶颈不在算法,在同城专线的抖动上。
可信执行环境呢。问题不在技术本身,在你信不信那个芯片厂商。侧信道攻击一轮接一轮,补丁打完又冒出新洞。这事的边界很清楚:它适合对性能敏感、对信任模型能接受的场景。不是万能钥匙。
还有个特别土的坑——网络。两家机构的网打通,光流程走两个月。这跟技术一点关系都没有。全是流程。
真要用,先干这几件事
第一件,别急着问技术方案,先问业务。你到底想算出一个什么数?这个数会不会反过来推出原始数据?想不清楚这个,后面全是白搭。
第二件,拉三方评审。业务、安全、法务坐一桌,把数据流图摊开来一起看。别让安全最后才进场,那时候架构已经焊死了,改不动。
第三件,从小场景切。黑名单撞库查询、简单的样本交集统计,先把链路跑通。别一上来就搞联合建模,那是给自己挖坑。
第四件,把性能指标写进合同里。P99延迟、并发量、单次计算成本,一个都不能含糊。不然上线之后就是扯皮。
第五件,想好退出机制。参与方中途要撤出,已经训练出来的模型归谁?这问题现在不问,将来更问不清。
说实话,隐私计算这东西,不是买个产品装上就完事的。
它更像一种长期的协作关系。技术能解决数学问题,解决不了信任问题。而绝大多数项目卡住,卡住的恰恰是后者——那个喝茶老哥的项目,最后也不是靠技术推过去的,是靠两家单位一把手坐下来吃了顿饭。
饭桌上的事,机房里的东西替不了。