去年双11前一周,我们组的支付接口突然偶发超时。
报错率稳定卡在0.3%。
不高但架不住离大促只剩7天,老板在群里@所有人的时候,连表情包都没带。
一开始查日志,网关说请求已经转到订单服务,订单服务说我已经把请求丢给库存服务,库存服务说我啥也没干就是等数据库连接等了两秒。三个团队的研发抱着各自的日志页面对峙了快8小时,每个人都在翻对应traceId的日志行,眼睛熬得通红,最后才揪出原因——库存服务上周新加的缓存预热线程,偷偷把数据库连接池占了大半,正常的扣减请求排不上队。
要是当时有能用的链路追踪,根本不用这么折腾。
你以为的链路追踪,不是你真的能用的链路追踪
很多团队对链路追踪的认知还停留在“装个开源工具就算落地了”。
我见过太多团队,上来就把SkyWalking的全量探针接上,所有服务的CPU占用直接涨了20%-30%,业务性能掉了一大截,运维扛不住压力,不到一周就把探针全卸了,最后得出结论“链路追踪没用”。
还有更离谱的,去年去一个做电商的朋友那边交流,他们花了三个月搭了整套链路追踪平台,存储买了整整两TB,结果排障的时候打开平台,看到订单服务的总耗时800ms,点进去只有一个粗粗的span,标着“调用库存服务”,至于这800ms里是库存服务查商品慢了,还是扣减库存的时候等锁了,完全没有记录。绕了一圈,还是得回去翻应用日志。说起来都好笑,他们当时为了这个平台,专门招了个运维来维护,结果运维自己都吐槽,这东西查问题还不如自己写个grep脚本快。
很多人以为traceId是自动在所有服务之间飘的,实际上只要任何一个节点没接对,这个ID就会丢,整个链路就断了。
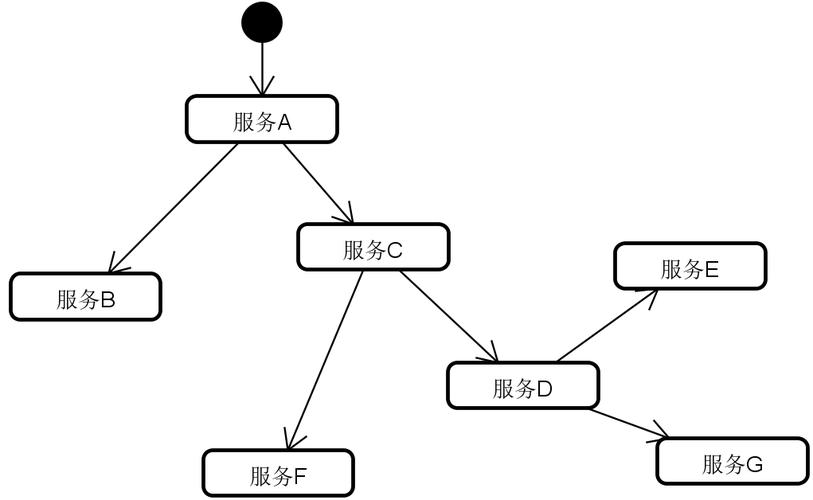
对,这就是最常见的误区——把“有链路追踪平台”等同于“链路追踪落地了”。实际上大部分团队的链路追踪,从接入第一天起就是个半残的摆设。对吧,花了大价钱搭的平台,最后还不如翻日志快。
别把链路追踪只当排障救火的工具
说实话,最早我也觉得这东西就是出故障了用来找根因的,直到那次靠它省了几十万的云成本,我才彻底扭转了认知。
当时我们日常拉链路报告,发现一个老的用户中心接口,每次被订单服务调用的时候,要串行打三个内部接口:查用户等级、查用户优惠券、查用户收货地址。每个接口的单耗时都在正常阈值里,三个加起来光网络往返就花了210ms,占了整个下单链路耗时的15%。
之前从来没人注意到这个问题。毕竟每个接口单独看都没毛病。
后来把三个串行调用改成批量聚合查询,整个下单接口的耗时直接降了28%。算下来一年省下来的云服务器带宽和计算成本,够给整个团队发两次季度奖。
还有一次,链路平台自动告警,说每天凌晨两点的用户画像同步任务,占了核心交易链路12%的数据库连接资源。要是等白天用户访问的时候才发现连接池被打满,那指不定要出多大的线上事故。
别等炸了才找。
早看早省。
落地别贪大,先把最痛的链路跑通

很多团队落地链路追踪失败,本质上就是太贪大。
一上来就要求所有服务、所有接口全量接入,所有方法、所有数据库调用全量埋点,结果存储成本涨上天,探针把业务性能拖垮,最后没人愿意用。
我现在给团队推链路追踪,第一原则就是别贪多。
先挑你们团队最容易出问题、排障最费劲的三条核心链路——比如支付下单、用户登录、核心报表查询。就这三条,别的链路一概不管。埋点的时候也别瞎加乱七八糟的标签,就记三个核心数据:每个节点的进入时间、退出时间、报错堆栈。别把什么用户ID、商品ID、订单ID全打在标签上,占存储不说,查的时候信息太杂反而找不到重点。
还有个最容易踩的坑,异步线程的上下文传递一定要提前测。很多人接入完探针就以为万事大吉,结果上线了才发现,只要是异步线程里的调用,traceId直接就断了,链路图上全是碎的节点,根本串不起来。我们当时第一次接入的时候,就踩过这个坑:发消息的异步线程没传traceId,结果整个消息消费的链路全是独立的碎块,查问题的时候根本对不上,前前后后补了一周的上下文传递代码才理顺。
最后算笔账,我们现在只接了三条核心链路,链路存储的成本从一开始预想的每月两万多,降到了每月三千不到,排障时间从原来的平均40分钟,压到了5分钟以内。
技术工具从来不是越全越好,越贵越好。
能帮你少熬几次大夜,少背几次锅的,就是好东西。