上周蹲在新街口那栋老写字楼的机房边,盯着满屏跳红的告警,运营的电话都快把我手机打冒烟了。他们做了三年K8s,上了三套监控工具,愣是没找出到底是哪个微服务在大促时拖垮了订单链路。
没用的。真的。
先别忙着堆工具
说实话,我见过至少七成做云原生的团队,一提可观测性,第一反应就是把市面上能叫得出名的开源工具全装一遍。装完就觉得万事大吉,真出问题的时候才发现三个系统的数据根本对不上,运维要在三个浏览器标签页之间来回切,等把所有信息拼出个大概的时候,故障早就影响到用户了。
他们家当时就是这样:指标是Prometheus采的,日志是ELK存的,链路是Jaeger抓的,三个系统各自独立,连个统一的关联ID都没有。对吧,本来同一个用户的下单请求,在网关的日志里有记录,在订单服务的链路里有耗时,在数据库的慢查询里有痕迹,结果这些信息散在三个地方,没人能快速拼出完整的故障现场。
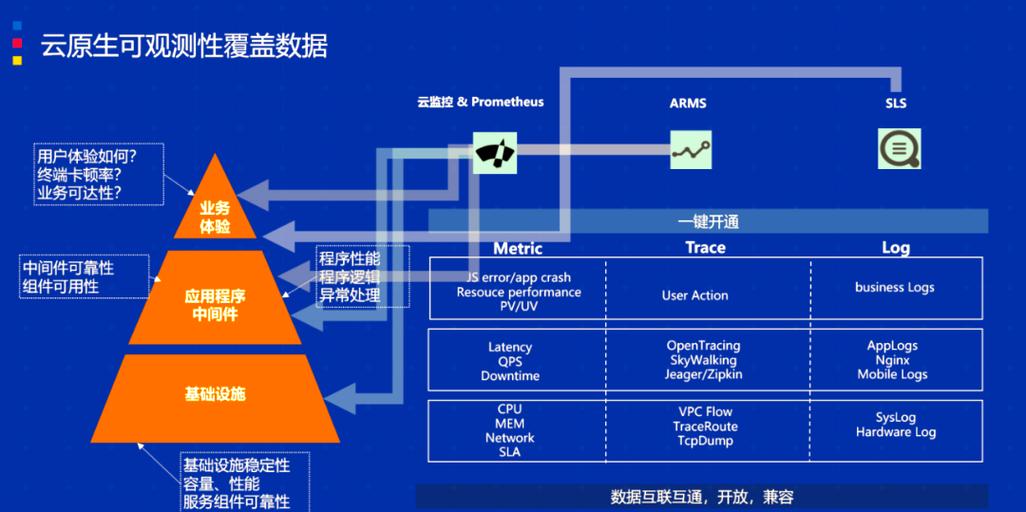
我当时看着运维小哥对着三个屏幕来回切换的样子,都替他累。那种面板画得再炫酷,没有数据关联的可观测性,本质上就是个更贵的摆设。
别追求一步到位的完美体系
不过话说回来,也不是说要做可观测就完全不用考虑扩展性,只是很多团队一上来就喊着要做全链路可观测,从边缘节点到数据库到中间件,所有组件全量埋点,结果光埋点的需求就排了三个月的期,最后业务迭代都快把这事忘了。
当时帮他们梳理的时候,我直接劝他们把那些非核心的边缘服务先放一放,就先抓三个最要命的核心链路:用户登录、商品下单、支付回调。就这三个。
埋点也不搞复杂的,先把这三个链路上所有服务的trace ID全串起来,不管是K8s的Pod重启日志,还是Redis的慢查询,还是网关的限流日志,只要能和trace ID对上,就自动关联到同一条链路里。没有买新的商业工具,就是加了一层很轻的关联规则,把原来三套工具的数据打通而已。
可观测性的核心从来不是采集了多少数据,而是能不能在出问题的第一时间,顺着一个线索把所有相关的信息全捞出来。

前后也就花了两周。第二次压测的时候,有个服务因为内存泄漏导致接口超时,以前要找半小时才能定位到是哪个Pod的问题,这次点一下告警,直接就能看到对应的Pod的内存曲线、这个Pod上所有的错误日志、还有这条链路上每个环节的耗时分布,前后不到两分钟就把问题定位了。当时运维小哥当场就给我递了瓶冰可乐。
别让可观测性变成运维一个人的事
很多团队觉得可观测性就是运维的活,开发只管写代码上线,出了问题就甩给运维排查。这种团队我见太多了。开发写代码的时候连个规范的日志都不打,出了问题就对着运维喊“我本地跑是好的啊”。
我们当时给他们定的规则也不复杂,没有搞什么复杂的考核,就一条:通用的组件状态由运维统一采集,核心业务链路的埋点由对应服务的开发负责。所有核心链路的服务,开发提交代码的时候,必须带上对应链路的埋点校验,没有埋点的代码不准上生产。
刚推这个规则的时候,有个开发还吐槽说增加工作量。结果后来有次他们写的优惠券服务出了故障,他自己在工位上花三分钟就从可观测面板里看到是优惠券规则配置错了,没等运维介入就自己改完上线了,后来他比谁都积极给其他服务补埋点。
前几天那个公司的运维给我发消息,说上个月618大促,他们整个峰值期都没出现过找不到问题的情况,整个团队的加班时长比去年少了六成。
挺好的。