去年冬天陪前同事在机房蹲到三点,机房空调坏了,冷风裹着服务器风扇的嗡嗡声往脖子里钻,他盯着监控屏上跳红的接口,攥着半瓶凉透的可乐骂,说当初为了省那点钱,只做了单机房部署,现在大促前压测直接挂掉,连回滚的余地都没有。
别把多活当成高可用的唯一标准答案
很多人一提高可用,上来就说要做三地五中心,要全链路多活。别迷信。
多少小团队连自己的核心流量峰值是多少都摸不清,上来就抄大厂的方案,光一年的云资源成本就够养三个后端了。上次见个做本地生鲜的团队,日活才不到十万,非要搞双机房部署,结果同步数据的带宽费比他们整个运维团队的工资还高,后来真出故障了,切流量的时候才发现两边的库存数据差了三千多单,差点把供应商给搞崩。
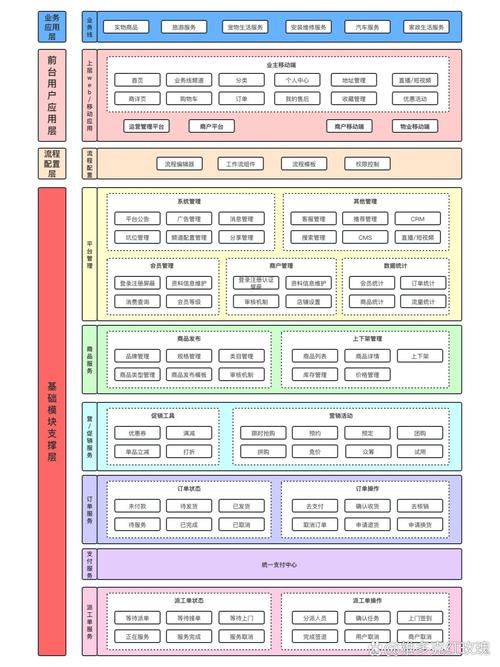
其实高可用的核心从来不是“不挂”,而是挂的时候你能扛住多大的损失,多快能恢复。你一个内部用的OA系统,就算挂半小时,能有多大损失?犯得着搞多活吗?最多做个定时备份,数据库开个主从,真挂了切主库也就十分钟的事,成本不到多活方案的十分之一。
那些没人告诉你的高可用隐性成本
很多人算高可用的账,只算买服务器、买云资源的钱,不算那些看不见的成本。
头一个就是运维的复杂度。多一套节点,你就要多一套监控,多一套告警规则,多一套故障排查的流程,原来三个人能搞定的事,现在要五个人轮班盯,半夜三点出个告警,所有人都得爬起来处理。还有数据一致性的坑,你做多活,跨机房同步数据的延迟怎么解决?用户在A机房下了单,B机房的库存还没更新,直接就超卖了,这种事我见过不下十次。
更别说测试成本。你每次改个功能,不光要测主集群能不能跑,还要测灾备集群能不能正常切流,测试用例的量直接翻一倍,原来两天测完的版本,现在要四天才能上线,迭代速度直接砍半。

说实话,这些成本加起来,有时候比你宕机一次的损失还高。之前有个做在线教育的团队,算过一笔账,他们之前为了做99.99%的可用性,一年光隐性成本就花了两百多万,结果真出故障的那次,是因为运维误操作删了库,损失也就二十来万。你说冤不冤?
普通团队能落地的高可用最小方案
别上来就抄大厂的作业,先把最基础的事做好。
先把故障的应急预案写在纸上,别存在脑子里。多少团队的运维故障处理流程,全靠老员工的记忆,老员工一离职,新人遇到故障直接懵,连先切哪个开关都不知道。
核心链路的超时设置别乱配。我见过太多接口超时设成30秒的,整个服务线程全堵在那,直接把整个集群拖垮,其实你一个下单接口,用户最多等3秒,超过了直接返回“系统繁忙,请稍后再试”,反而能扛住更大的流量。
数据库的主从切换别手动来,搞个自动切换的组件,真主库挂了,十秒之内自动切,比你半夜爬起来登服务器操作靠谱多了。还有,定期做故障演练,别等真出问题了才发现备份的文件根本恢复不了。上个月有个团队做演练,才发现他们连续三个月的数据库备份都是坏的,原因是备份脚本里的路径写错了,存了一堆空文件,当时整个团队都吓出一身冷汗。
高可用这个事,从来不是一劳永逸的项目,是你每天盯着监控,每次故障之后复盘,一点点磨出来的。别信那些卖方案的人说的,买个产品就能实现百分百高可用。真那么容易,哪还有那么多半夜爬起来处理故障的运维?