上周跟个做电商的朋友吃饭,他说刚背了个差点被开的锅。大促前改了库存扣减逻辑,上线半小时,前端显示的库存和实际仓库对不上,超卖了三百多单。
这事说穿了就是分布式缓存一致性保障没做到位。很多人上来就谈各种理论模型,什么CAP、BASE,背得滚瓜烂熟,真到生产里,该踩的坑一个没少。
你以为的同步双写 其实是定时炸弹
很多团队刚上缓存的时候,图省事,改完数据库,再删缓存。听着没问题对吧?麻烦在于,数据库事务提交的瞬间,刚好有个请求读了旧的缓存值,你删缓存删早了,那这个旧值又会被重新写回缓存。

就这一下。
旧值会在缓存里待满整个过期时间。
没人能提前发现。
有人说那我改完数据库再更缓存?更扯。两个写操作,没有事务保证,要么数据库成了,缓存没更,要么缓存更了数据库挂了。更离谱的是,分布式环境下,两个不同的实例同时改同一个key,顺序乱了,后到的旧值把新值盖了。
说白了,只要你把缓存和数据库的写操作拆成两个独立步骤,就永远有缝隙。
别迷信最终一致 你得算清楚代价
很多架构师张嘴就来,我们要最终一致,不要强一致。说这话的时候,根本没算过业务能容忍的不一致窗口是多久。
比如你做的是内容平台,用户发个动态,半小时后才显示,用户可能直接卸了。要是做的是商品浏览量,不一致个几分钟,根本没人在乎。
分布式缓存一致性保障从来不是技术问题,是业务问题。
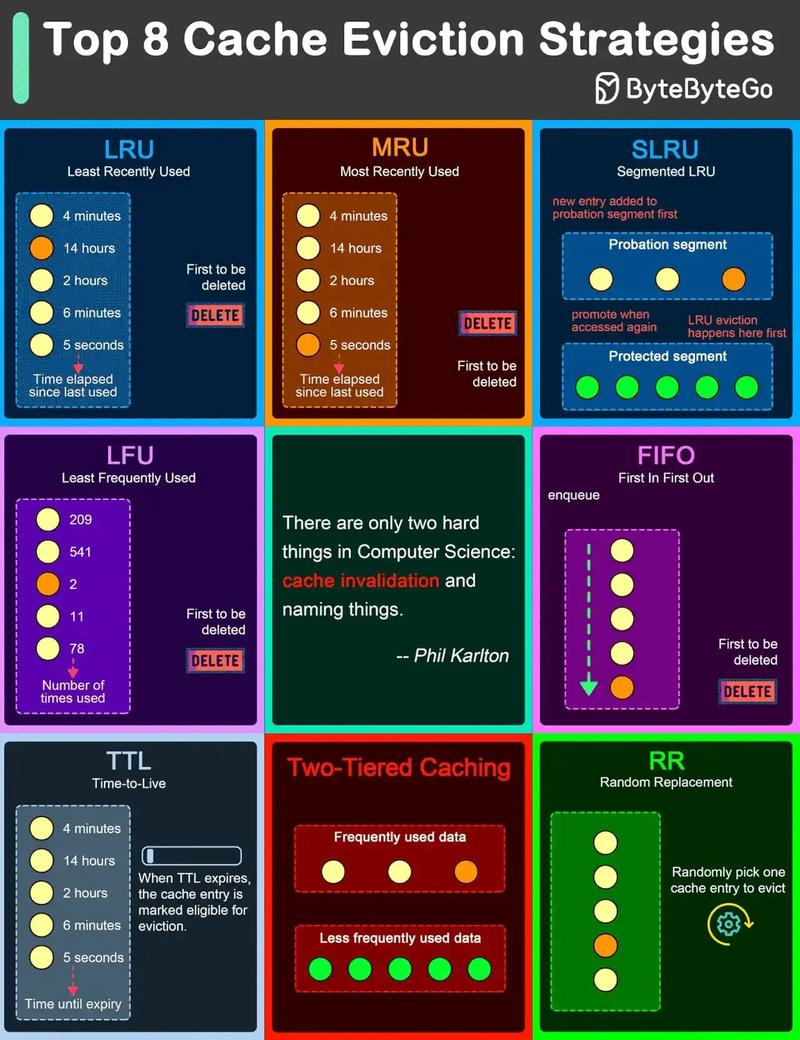
之前见过个团队,给所有缓存key统一设了5分钟过期,说这样不管出啥问题,最多5分钟就恢复。结果他们做的是票务系统,演唱会门票的库存,5分钟能超卖几千张。
强一致的代价是什么?你要把写操作的链路串起来,写数据库、删缓存、发消息通知其他节点,每多一步,延迟就涨一截,吞吐量就掉一块。你要是扛不住这个流量,就别硬上强一致。
别跟我说什么大厂的方案,大厂的流量是大厂的,你的业务量到了那个级别再抄也不迟。小团队上来就搞分布式事务、本地消息表,光维护成本就能把你拖死。
那些没人愿意说的兜底手段

别总想着用完美的架构解决所有问题。一线干活的人都知道,再好的逻辑,也有漏的时候。
比如,给核心的key加个短周期的强制过期,哪怕逻辑出问题,最多几秒就恢复。比如,做个后台的对账任务,每隔10分钟扫一遍核心数据,发现缓存和数据库对不上,直接把缓存删了,让请求回源。
还有,写的时候,别直接删缓存,延迟双删个几百毫秒再删。就这一个小改动,能挡掉90%的双写冲突。
很多人觉得这些手段太土,不够优雅。但生产里跑的系统,能少出故障的,就是好架构。
核心链路的对账兜底,是你在半夜被报警叫起来的时候,能少掉头发的关键。别总想着靠架构一次解决所有问题,先把漏补上再说。
还有个最实在的原则:不要为了非核心业务的一致性付出过高的性能代价。用户头像的缓存不一致个10分钟,没人会找你麻烦。但库存、订单、支付这类核心数据,哪怕多花点性能成本,也得把一致性兜住。
昨天那个朋友的团队,最后把库存相关的key过期时间从1小时改成了10秒,加了个每5分钟一次的对账任务,大促扛下来了,没再出超卖。
没什么玄乎的。
分布式缓存一致性保障,从来不是给你拿出去吹的技术名词,是你半夜被报警叫起来改bug的时候,能少熬两个小时的保障。