去年618前两周,运维群直接炸了。
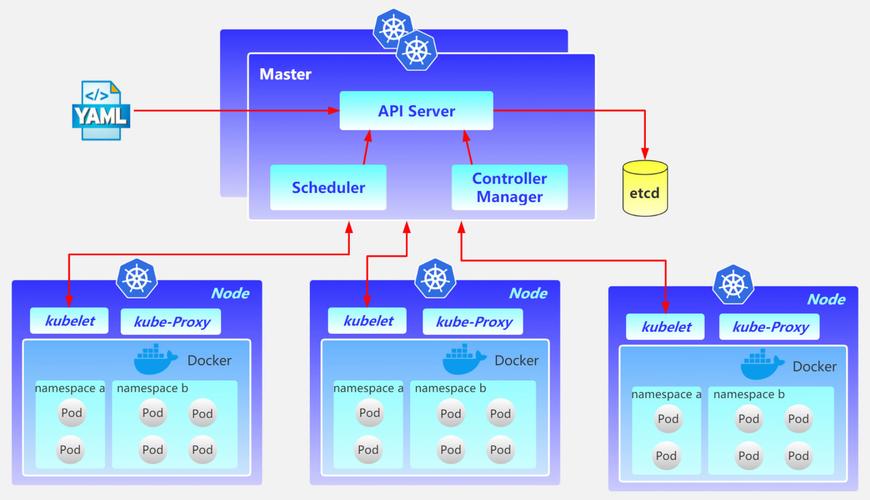
三个集群跨了两个可用区,一个存核心订单数据,一个跑大促的营销活动页面,还有个本来该独立的测试集群,不知道什么时候被人混进了半组生产节点。那天压测团队跑全链路压测,流量直接打到了订单集群的核心服务上,半小时内下单接口超时率冲到了40%,客服的投诉消息直接刷爆了企业微信。现在想起来还冒冷汗。
最初多集群的混乱起点
最开始搭集群的时候,大家都觉得多搞几个独立的控制平面,就是物理隔离,安全系数拉满。没人管版本统一,没人管权限回收,更没人想过跨集群的流量怎么调度。订单组图新,用的1.24版本,营销组怕升级出问题,还停在1.21,测试组更离谱,为了省机器,直接把闲置的生产节点加进了测试集群的节点池,打了个dev的标签就算完事。
那时候排障有多麻烦?要登三个不同的集群控制台,分别导日志,跳来跳去,半小时才定位到是压测流量走错了入口。那时候才反应过来,光靠多开集群凑数量,管理跟不上的话,比单集群出问题还难收拾。

当时排完故障就拉了个专项会,说要搞多集群的统一管理,一开始还想搞大的,直接上全量集群联邦,把三个集群的控制平面全打通,统一调度资源。结果试了一周直接打回原形——跨集群的服务发现延迟比预期高了3倍,营销活动的优惠券接口跨集群调用直接超时,用户点了三次领不到券,运营那边先炸了。
真正落地时绕不开的务实选择
我们没有上来就搞全量的集群联邦。
先从最基础的入口统一开始搞。把所有集群的服务入口全接到同一个多集群API网关下面,每个集群的节点重新打标签,标清楚业务线、运行环境、所属可用区,把之前那些乱打的dev-test-prod四不像标签全清了。这步花了整整三天,负责清标签的同事那三天天天在群里吐槽,问当初是谁随便给节点加标签的。
权限的问题是同步解决的。之前每个同事手里都有各个集群的admin权限,谁想删个namespace根本没人拦着。后来对接了公司统一的SSO,用OIDC做身份校验,只给业务负责人开对应集群的namespace管理员权限,普通开发连节点列表都看不到。就这一步,之后再也没出现过测试同学误删生产资源的乌龙。
配置同步的方案我们最后选了ArgoCD,每个集群都装一个agent,统一从公共的Git仓库拉取配置,再也不用手动登每个集群敲kubectl apply了。之前每次发版要登三个集群分别操作,现在提交个PR,合并之后自动同步到所有对应环境的集群里,省了至少一半的发版时间。
现在还在填的没做完的坑
哪有什么一步到位的完美方案。
跨集群的监控数据打通到现在还没搞定。最开始想搞Thanos把所有集群的监控数据全存到一块,结果算下来跨可用区的流量成本一个月要多花两万,领导直接把方案打回来了。现在就先凑合用,把核心订单相关的指标同步到一个公共的Prometheus里,非核心的营销、测试集群的监控数据就各存各的,查的时候多跳两个面板的事,也能接受。
版本升级的问题更头疼。三个集群现在还卡在1.25,想升到1.27,但是现有的多集群证书轮换脚本还没适配新版本,每次升一个集群就要花半天时间导出旧证书,手动替换到各个节点上。上个月升级其中一个集群的时候,差点把控制平面的etcd搞挂,现在想起来还发慌。
哦对,还有成本的问题。之前为了隔离,每个集群都单独留了20%的冗余资源应对峰值,算下来光闲置的资源一年就要多花小几十万。现在正在慢慢调整,把非核心的业务节点调度到可抢占的实例上,能省一点是一点。
其实到现在也没人敢说我们的多集群管理方案是行业标杆。最开始总觉得要上最复杂、最先进的技术架构,才算技术实力到位。折腾了大半年才发现,能让团队不用天天熬夜排障,大促的时候能踏踏实实喝着咖啡盯流量,比啥花里胡哨的架构都强。
上个月新入职的后端同学找过来吐槽,说想在测试集群跑个压测任务,发现自己只有dev namespace的权限,填了工单等了半小时才批下来。他说之前在老东家,手里有生产集群的admin权限,想敲什么命令就敲什么,总觉得心里不踏实。现在反而觉得,这种处处受限的感觉,特别稳。