上周在软件园区楼下的咖啡馆,碰到个做电商的后端工程师,抱着笔记本骂了快半小时。说大促零点的瞬间,用户下单请求打进来,订单系统同步调用库存、优惠券、积分三个下游接口,CPU直接飙到92%,整个链路卡了三秒,后台统计下来丢了快两千单。他说之前翻了几篇架构文章,说上消息队列就能解决耦合问题,花了三天搭好Kafka集群,结果上线第一天就因为消息重复消费,给同一个用户发了五张无门槛满减券,亏得运营追着他跑了三层楼。
你以为的解耦,其实是埋雷
很多人对消息队列的认知,还停留在”把同步调用改成异步,系统响应就能快一倍”。说白了,这玩意最开始被造出来,根本不是为了让你接口响应变快的——最早是金融行业为了跨网点传输交易流水,怕网络中断丢数据,才搭建的可靠传输通道。
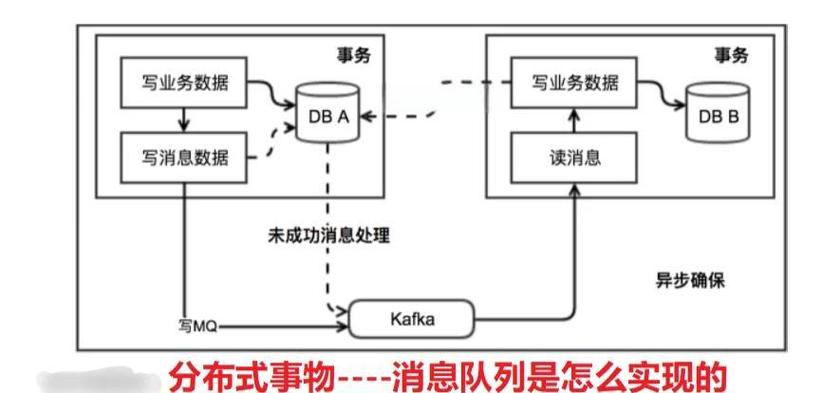
麻烦在于,太多人只看到异步的好处,没算过引入之后要接的烂摊子。比如你原来的同步链路,下单接口调用库存服务,成功就返回成功,失败就直接把错误抛给用户。上了消息队列之后,订单服务发完消息就立刻给用户返回”下单成功”,结果消息在通道里卡了十分钟,库存服务那边根本没收到投递。用户等了半小时没收到发货提醒,回头找客服才知道,这笔单压根没进入库存系统的处理流程。
引入消息队列的第一笔隐形成本,是你必须接受”最终一致”,而不是”立刻一致”。很多团队刚落地的时候,根本没意识到这个认知差。用户那边看到下单成功的提示,结果过了半小时才走库存扣减流程,碰到库存不足的情况,还得反过来给用户打电话道歉,说刚才那单其实没抢到。这种体验,比直接告诉用户”当前下单人数过多请稍后再试”还差。
没有银弹,只有你愿意为哪个代价买单
消息队列从来不是什么架构升级的万能钥匙。你选RabbitMQ,延迟低,路由规则灵活,但是堆到百万级消息积压的时候,消费端的恢复速度能慢到让你怀疑人生。你选Kafka,吞吐量是够了,但是单条消息的延迟比RabbitMQ高两个量级,碰到需要精准路由到不同消费队列的场景,配置规则能让你挠破头。你选Pulsar,存算分离的架构听着很高级,但是中小团队根本养不起能熟练调优它的运维,光做个合理的容量规划,就要占掉两个工程师半个月的工作量。
我之前碰见过个做内容社区的技术团队,为了追技术潮流,把原来用了两年的RabbitMQ换成了Pulsar。换完之后才反应过来,他们每天的消息总量才不到两百万,RabbitMQ单节点都能稳稳扛住。换Pulsar之后,光集群部署和配套监控,就多花了三万多的服务器成本,最后吞吐量根本没提升多少,反而因为对组件不熟悉,一次消息积压没及时触发告警,导致用户的评论通知晚了四个小时才发出去。
选型从来不是选功能最多的那个,是选你团队能hold住的那个。这话听着朴素,但是真的能想明白的团队不多。
那些没人写在官方文档里的坑
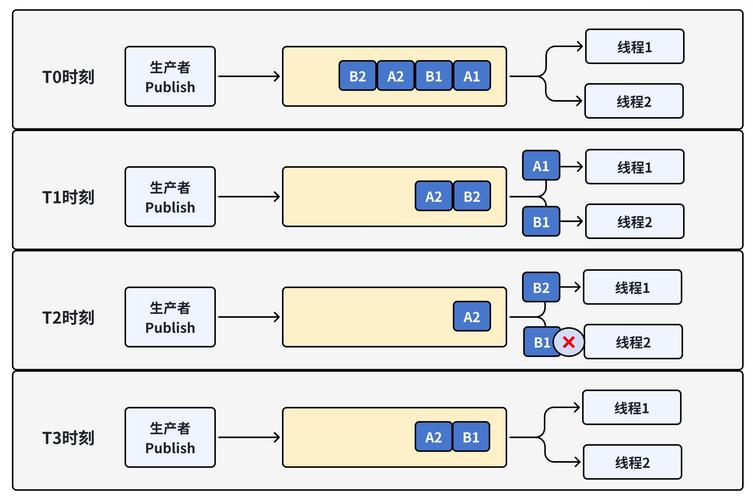
官方文档只会告诉你消息队列怎么发送消息、怎么配置消费组、怎么开启消息持久化。不会告诉你,当你的消费端因为程序bug意外重启的时候,没处理完的消息会不会被重复投递。也不会告诉你,当消息积压到百万级的时候,你之前设置的消费速率限制,会把整个故障恢复的过程拉得无限长——我见过最离谱的一次,团队碰到消息积压,为了快点追平消费进度,临时把消费并发拉到了原来的十倍,结果下游的业务数据库直接被打挂,本来只要半小时就能消化完的积压,整整花了八个小时才恢复,中间整个团队熬到凌晨两点。
还有个常见的疏漏,很多团队部署完消息队列,根本没搭死信队列。消息发出去,消费失败,重试三次还是失败,就直接悄悄丢了。丢了也没设告警,等过了半个月,财务对账的时候发现有几十万的流水对不上,才查出来是那些失败的消息根本没落地。
说实话,我现在碰到有人上来就说”我们要上消息队列做架构解耦”,第一反应不是夸他技术先进,是先问他三个问题:你能接受消息延迟的最长时间是多少?你有没有算过重复消费的兜底方案?出问题的时候你能多久把积压的消息消化完?
如果他答不上来,那大概率是看了几篇架构文章,就想把消息队列当遮羞布,掩盖自己原来系统里同步调用耦合太严重的问题。
这事没那么玄。消息队列本质就是个帮你传消息的快递站。你不能指望开个快递站,就把所有的物流问题都解决了。快递站会丢件,会压件,会因为爆仓把你的包裹堆在角落半个月找不到。你要做的,不是一开始就选个最贵的快递站,是先想清楚你要寄的是啥——是怕晚到的急件,还是可以等两天的普通包裹,是丢了要赔很多钱的贵重物品,还是丢了也没多大影响的宣传页。
上周碰到那个因为发券亏了钱的后端,后来把消息队列的消费逻辑改了。给每个用户的发券请求加了全局幂等校验,又给消息通道设了端到端的延迟告警,现在大促的时候虽然还是会有几万条消息的积压,但是再也没出现过重复发券的乌龙。他说现在才明白,原来之前以为上了消息队列就能高枕无忧,其实只是把原来系统里的矛盾,从同步调用的接口超时,转移到了消息通道的可靠性上。
没有一劳永逸的架构。
只有不断填坑的工程师。