上周跟南京软件大道某社区电商团队的后端负责人吃鸭血粉丝,他咬着块卤鸭肝突然拍桌子,说上个月刚把线上那套裸奔的接入层换完,之前三个月的破事差点把整个后端组逼到集体提离职。
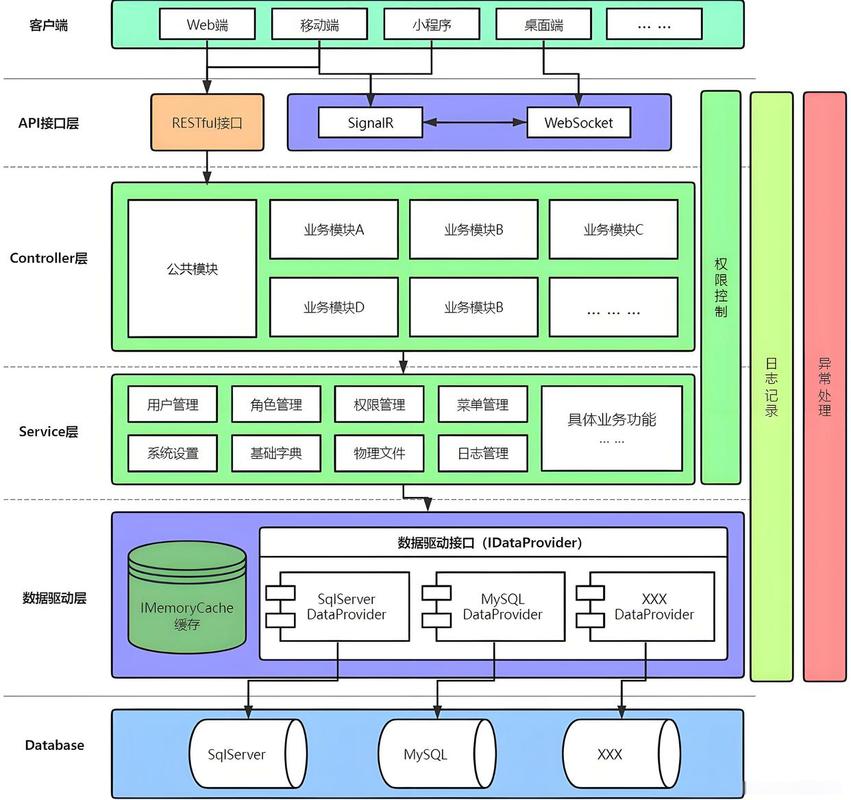
啥破事?最开始团队小,前端、小程序、运营的活动页,直接连各个微服务的接口,谁要新接口了,直接找对应的后端开发要个内网地址,写死在前端代码里。一开始几十套接口,大家熟得很,改个地址在群里喊一声就完事。
后来呢?业务涨了,光面向C端的接口就有两百多个,还有给运营后台、供应商端、同城配送员端的三套内部接口。乱套就来了。
比如上次618大促,同城配送的接口被恶意刷,有人写脚本爬配送员的实时位置,直接把配送服务的CPU打满到98%,整个南京区域的订单配送状态全查不到。那时候大家才反应过来,根本没地方加统一的限流。
还有更离谱的,有个后端开发改了用户服务的接口字段,忘了给前端同步,直接导致整个小程序的个人中心打不开,最后排查了两个小时,才发现是内网地址直连的问题——他改完自己测试完就把代码发上去了,根本没经过统一的校验。
为啥大家总把API网关当成“多装一个中间件”
说实话很多团队对API网关的误解,就是觉得这东西就是个转发请求的nginx升级版,多装一个东西,多占一台服务器,纯属增加运维负担。
真不是。
你想啊,没有网关的时候,所有的请求校验、权限判断、限流熔断、日志埋点,全要每个微服务自己写一遍。用户服务要写一遍token校验,订单服务要写一遍,配送服务还要写一遍。写三遍就算了,万一哪个版本的校验逻辑漏了个漏洞,比如之前有个团队,订单服务的token校验没加过期时间判断,直接被人爬了全平台的订单数据。
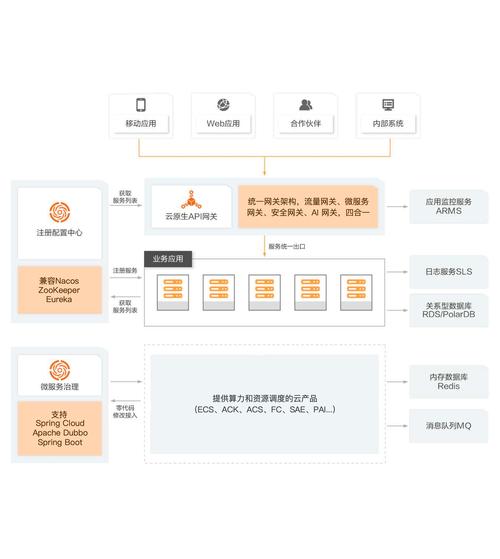
真正的API网关,本质是把所有跨服务的通用逻辑,从各个业务代码里抽出来,统一放在最靠近用户的那一层做。
比如token校验,不用每个服务写,网关收到请求第一时间就校验,没通过的直接挡在外面,根本进不到业务服务里。限流也一样,哪个接口每秒能扛1000个请求,哪个接口一秒钟超过100个就返回提示,全在网关层配好,根本不用业务代码写一堆限流逻辑。
我之前见过最夸张的团队,五个微服务,每个服务的日志格式都不一样,出了问题排查要登五个服务器拉日志,找了三天才找到一个偶发的接口超时问题。后来把日志埋点全挪到网关层,现在所有请求的耗时、返回码、来源IP,统一存在同一个日志库里,搜关键词三分钟就能定位问题。
别一上来就追着性能参数选网关
我见过太多技术团队,选API网关的时候,上来就拉个对比表,看哪个QPS高,哪个内存占用低,选完就往生产环境堆。根本不看自己团队的实际情况。
比如刚才说的那个南京的社区电商团队,最开始选的是某开源的高性能网关,压测的时候单机能扛5万QPS,觉得特别牛。结果上线才一周就崩了——为啥?他们团队根本没有能看懂这个网关源码的人,配个简单的跨域规则,翻了三天文档都没搞明白,最后还是找了个外包的技术专家,花了两万块才把基础配置弄好。
不过话说回来,那些上来就吹自己网关性能拉满的销售,根本不管你团队有没有能力维护这东西。
反过来,他们现在换的是个配置界面特别友好的开源网关,单机能扛2万QPS,对他们现在的业务量来说完全够。关键是啥?团队里的前端开发、后端开发,甚至负责运营活动的产品经理,都能自己在上面配个简单的接口限流规则,加个临时的活动接口白名单,根本不用每次都找运维。
对绝大多数中小团队来说,API网关的配置友好度、文档完善度,远比极限性能参数重要得多。
真正能落地的网关改造从来不是一步到位
很多团队一提要上API网关,就想着要在一个月之内把所有的接口全迁过去,所有的通用逻辑全配完,最后往往是项目拖了三个月,业务方怨声载道,说影响正常开发进度。
真没必要。
我给那个南京团队出的方案是分三步:第一步,先把所有面向C端的接口迁过去,先把统一的token校验、基础的访问日志加上,就这俩功能,上线当天就挡掉了之前30%的恶意爬虫请求。第二步,过了两周稳定运行了,再把限流、熔断的规则配上,哪个接口容易被刷,先给哪个加保护。第三步,等大家都习惯了网关的存在,再慢慢把跨域、灰度发布、接口版本管理的功能加上。
整个过程花了快两个月,没有影响任何一次正常的业务迭代。
上次他们的运营要做个本地的小龙虾节活动,要临时给活动页的接口加个100QPS的限流,之前要找后端改代码、提测试、发版本,走流程要两天。现在运营自己登上网关后台,输个规则,十秒钟就搞定了。
现在他们的网关上面,还配了个小功能:所有从南京本地IP过来的请求,会自动匹配对应的同城配送服务集群,不用请求绕到广州的中心机房,用户打开小程序的速度快了将近40%。
其实哪有什么高大上的技术架构啊。所谓的好技术,从来不是能扛多少QPS,而是能实实在在帮团队少踩点坑,少加几个没必要的班。