Kubernetes多集群管理实践落地手记
2026-11-12 21:14:13
作者:
fawen
上个月帮电商客户排障,三个集群同时报证书过期告警,值班同学拿着三个不同版本的kubeconfig来回切,敲错命令差点把生产环境的副本数缩到0。
现在想起来还捏一把汗。
之前刚接触多集群的时候,总觉得那些把集群拆得七零八落的团队是没事找事,直到自己踩了一次etcd脑裂的坑,才懂拆集群真的是被逼出来的。
为什么没人愿意在单集群里死磕
很多技术团队一开始的想法都很朴素:单集群能扛就扛,拆成多集群光维护成本都要翻几倍,纯属自找麻烦。
真的别硬扛。
我们之前服务的一个内容平台客户,硬把3200个节点塞在一个单集群里,etcd每次做全量快照要跑42分钟,版本升级一次要停核心服务近8小时,遇到大流量峰值时,apiserver的响应延迟直接飘到2s以上,前端的配置改动点了提交要等半分钟才生效。
拆集群的触发点其实从来不是什么技术潮流。
说穿了都是被问题逼的。
要么是合规要求:支付域的核心数据,必须和公共内容域的集群物理隔离,连网络都不能走同一条专线;要么是地域要求:东南亚节点和国内节点跨公网连同一个etcd,单跳延迟能到230ms以上,写个配置都卡半天;再要么是团队边界:运维、研发、SRE各管一摊,权限全搅在一个集群里,出了问题根本找不到第一责任人,互相甩锅能开一下午会。
 Kubernetes多集群物理隔离边界划分示意图
最开始踩的那些想当然的坑
 最开始踩的那些想当然的坑
刚拆完集群那会,大家觉得终于能松口气了,结果新的乱子比单集群时代还多。
最开始的想法特别简单:不就是多几个集群吗?做个统一的控制面板,把所有集群的kubeconfig都导进去,界面上点一下就能跨集群发命令,多爽。
结果呢?
面板的权限一开始配成了全局超管,有个刚入职的研发同学,本来想在测试集群删掉自己调试用的测试命名空间,手滑选了生产集群,幸亏当时值班同学盯着审计日志,紧急点了中断,不然整个生产环境的Deployment都要被清空。
现在想起来后背还冒冷汗。
第二个坑更常见。
每次改Ingress跨域配置,全靠运维同事写的bash脚本,挨个集群跑kubectl apply命令。上次改登录态的跨域规则,漏了华东区域的集群,整整17分钟,华东近40%的用户登录全跳跨域错误,客诉电话直接把客服团队的热线打满。
太痛了。
还有证书的问题。刚拆完集群的前半年,没人记每个集群的证书有效期,直到离到期只剩2天,告警才被人从消息列表里翻出来,三个集群的证书续期,三个值班同学熬了个通宵,第二天眼睛红得像兔子,连午饭都没胃口吃。
现在跑顺的落地逻辑
折腾了大半年,我们才摸出点不折腾的门道,根本不是什么高大上的架构设计。
首先,别一上来就追求“所有集群统一纳管”的完美状态。每个集群的kubeconfig单独存储,只有核心值班SRE能拿到集群级的最高权限,研发同学的权限只开放到自己负责的命名空间,对接公司的OIDC统一账号系统,员工离职自动回收所有权限,再也不用像之前那样,硬编码一堆长期有效的kubeconfig文件,散落在各个同事的电脑里。
然后,配置同步别搞人工兜底。用ArgoCD给每个集群打固定的标签,同一个应用的配置,只同步到打了对应标签的集群,改完配置推到代码仓库,所有匹配的集群自动拉取更新,不用挨个跑脚本。跨集群的资源同步,永远不要靠人工脚本兜底,人总会有漏看的时候,机器不会。
证书的问题更简单,每个集群开cert-manager的自动续期能力,提前90天就给运维群发告警,到期前自动完成证书轮换,再也不会出现证书过期的惊魂时刻。
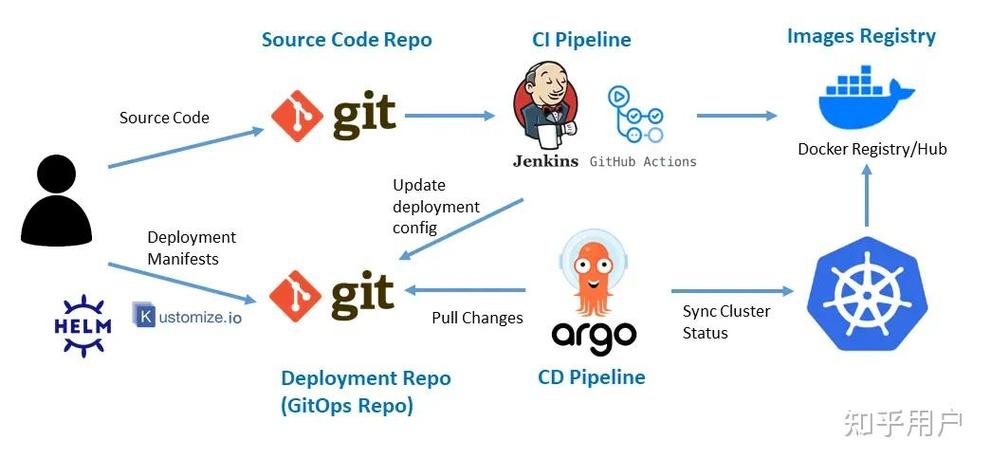 ArgoCD多集群应用同步架构流程图
很多人一提到多集群管理,就扯什么联邦集群、跨集群Pod调度、全局服务网格。说实话,我们现在还没敢碰。
跨集群的网络延迟、数据一致性问题,真的没有宣传的那么成熟。除非是真的有跨地域容灾的硬需求,不然老老实实把每个集群的运维流程做扎实,比追求那些花里胡哨的联邦特性有用多了。之前看同行硬上联邦集群,结果跨集群的Service访问延迟比本地高了3倍,最后又拆回去,来回折腾了小半年,人力成本花了几十万,对吧?何苦呢。
多集群管理从来不是什么炫技的技术架构,本质上就是把之前单集群时代的混乱,拆成几个边界清晰的小模块,每个模块的责任到人,少点人工操作,少点权限模糊,比什么都强。
上次那个电商客户的大促,三个集群所有的告警提前一周就处理完了,值班同学甚至能在值班点泡杯茶,不用攥着命令行手心冒汗。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:
Kubernetes多集群管理实践落地手记
文章链接:https://www.itcdj.com/news/762.html