上周跟某城商行的运维主管吃饭,他说上个月刚上了号称能降90%告警的AIOps平台,结果值班群里的告警条数没少多少,反倒多了个“平台识别为重复告警”的备注,翻起来更费眼。
告警降噪不是把告警条数压下去就算赢
很多厂商演示降噪功能的时候,最爱甩出来的数字就是“可降低80%以上无效告警”,但真到实际落地的时候,九成团队的降噪逻辑都是在玩数字游戏——把文本相似度高的告警堆成一组,对外报个合并后的条数,看起来数字好看,真要处理问题的时候,该漏的还是漏。
很多人对告警降噪的误解,是把“用户看到的告警条数”当成了唯一考核指标。去年跟某互联网团队的值班负责人聊,他们刚上降噪系统的第一周,就因为自动合并功能出了线上事故:一个核心服务实例CPU打满,连续触发了17条CPU使用率超过90%的告警,被系统判定为重复告警,只在值班渠道推了一次合并后的通知,等值班同学看到的时候,已经有三个下游接口超时,客诉都打到客服中心了。
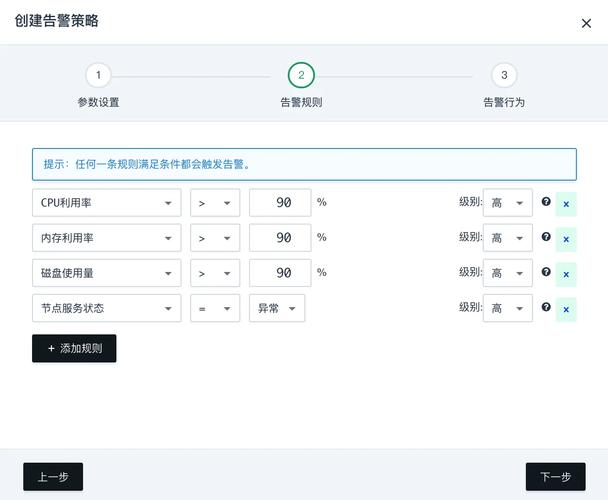
麻烦在于,告警的优先级从来不是靠文本相似度定的。同样是“磁盘使用率超过85%”的告警,核心交易库的磁盘告警,和测试环境压测机的磁盘告警,根本不是一个量级。大部分降噪系统上线第一步就走偏了——没先把所有告警对应的资产标签打全,上来就跑文本聚类,结果把高优先级的核心告警跟低优先级的测试告警堆在一块,值班的时候扫一眼看到是“合并类告警”,习惯性划走,真出问题的时候追悔莫及。
这事没那么玄。你不能指望一个刚上线两周、连你家核心系统有几个节点都没摸清楚的系统,能比值班三年的老运维更懂哪些告警是要命的。
根因定位不是给个弹窗结论就算完成
厂商演示根因定位功能的时候,场景永远是完美的:点一下“分析”按钮,几秒钟后就弹出个精准结论——“本次故障根因为数据库连接池耗尽”,连后续的处理建议都给你列得明明白白,看起来特别有冲击力。真到线上跑起来的时候,这类弹窗的准确率能到30%就算不错了。
上次碰到个团队,花了大价钱上的根因定位系统,某次核心接口响应超时,系统弹出来的结论是“机房出口网络抖动”,运维同学顺着链路查了半小时,发现根因是上游服务的日志采集配置错了,把全量请求参数都打到本地日志文件里,半小时就占满了节点的磁盘IO,导致整个节点的请求处理线程被阻塞,响应自然慢得离谱。
根因定位最容易踩的坑,是系统输出的“根因”只是相关性最强的那个指标,不是真的因果性结论。现在大部分公开的根因算法,本质上是基于历史告警的关联度计算——就是过去哪几个告警经常在同一时间段出现,就把关联度最高的那个节点标成根因。但线上的故障哪有那么多重复的?第一次出现的新故障,系统根本没有对应的历史样本,怎么可能直接给出百分百准确的结论?

很多团队为了追求根因定位的准确率,给系统灌了大半年的历史告警数据,结果系统认死了之前的关联规则,碰到新的故障模式,还是拿老套路上套,越用越不准。有个做了十年运维的老大哥跟我吐槽,说现在的根因系统,就像个刚毕业的实习生,碰到问题第一反应是“我之前在哪本书上看过类似的情况,应该是这个原因”,根本不会顺着调用链路一步步拆解验证。
别为了凑AIOps的概念硬上系统
我见过太多团队上AIOps,根本不是因为现有运维流程扛不住了,是看同行都在做AIOps实践,自己不上显得技术落后。比如团队一共就三个运维,管着二十多台物理服务器,每天全渠道的告警加起来也就二三十条,值班的时候抽半小时就能全部处理完,非得花几十万采购整套AIOps平台,光做数据接入、打通各个监控系统的接口就搞了三个月,最后平台本身的日常维护成本,比之前人工处理告警的成本还高。
说实话,AIOps从来不是所有团队的必选项。真正需要这套系统的场景,是那种管着几千个微服务节点、每天告警量几万条,人工根本看不过来的规模——这时候AIOps告警降噪与根因定位的能力,是真的能帮值班同学省大量时间,把精力从刷告警的机械劳动里解放出来,去做更有价值的事。但如果你的团队规模小,告警量根本没到人工处理不过来的程度,与其花大价钱买复杂的平台,不如先把现有告警的规则理清楚:把没用的测试环境告警全关了,把重复触发的告警阈值调合理,把每个告警对应的资产标签打全,这一套基础工作做下来,告警量可能直接降80%,比上什么复杂的智能系统都管用。
上次跟那个城商行的运维主管聊到最后,他说现在已经把之前那个平台的自动降噪功能全关了,改成了只做告警的标签梳理和关联展示,值班的时候看到关联的告警堆在一块,自己判断优先级,反倒比之前系统自动合并的时候靠谱多了。
工具终究是工具。你要是把工具的判断结果放在人的判断前面,出问题是早晚的事。