前年冬天,去河西一家做跨境生意的小公司喝茶。技术负责人老周把监控大屏转过来给我看,用户登录接口的 P99 延迟飙到 800 毫秒。代码?三个月没动过一行。
排查了两天,问题出在中间那条路上。应用部署在公有云,用户主数据躺在自建机房的物理机上,两边靠一条 100M 专线连着。白天跨境流量一上来,专线打满,请求排队。晚上安静了,指标又漂亮得看不出任何毛病。
老周那段时间的签名改成了「混合云,混合痛」。我当时笑,后来自己踩了一遍,笑不出来了。
混合云这词听着体面,说白了就是一部分算力在云上,一部分留在自己机房或者托管 IDC,两边要能说上话、要能统一管、账单还得算得清。听起来不难。真做起来,难点全在接缝处。

那条专线比你想象的贵得多

很多人算混合云的成本,思路是这样的:机柜费省了,服务器折旧省了,运维人力省了,划算。
我第一次认真对账,是在项目上线第五个月。账单上多出来三块:专线月租、跨区流量费,还有云上那一堆为了「兜底」而常年开着、却从没被调度过的闲置实例。前两块加起来,差不多等于原来机房的机柜和电费。第三块最气人——它是隐性的,没人盯着,就一直开着。
专线这东西,标称带宽和实际可用带宽是两回事。100M 的线,跑 TCP 长连接做数据同步,实际吞吐能到多少,取决于 RTT 和窗口。跨城跨境的线路,RTT 一高,吞吐掉得比你想的快。这不是云厂商黑你,是物理规律。要么加钱升带宽,要么改架构减少跨云调用。
改架构往往更便宜。我们后来把那套用户主数据做了读写分离,读走本地缓存,写批量走异步队列,压到夜里跑。专线还是那条,延迟没变,但白天没人排队了。
不过话说回来,有些东西真搬不动。数据库主库、老 ERP、带着加密狗的授权服务,这些短期内就是得留在机房。承认这一点,比硬扛着搞「全量上云」实在得多。
多集群管理没那么浪漫
混合云搭到第二年,集群数量会悄悄变多。生产一个、灾备一个、测试一个、还有个说不清用途的沙箱。Kubernetes 管一个集群是享受,管五个是折磨。
镜像仓库同步、ConfigMap 差异、网络策略不一致、证书到期时间各不相同。最要命的是发布。你在多云环境里推一次灰度,要确认的东西是单集群的好几倍。
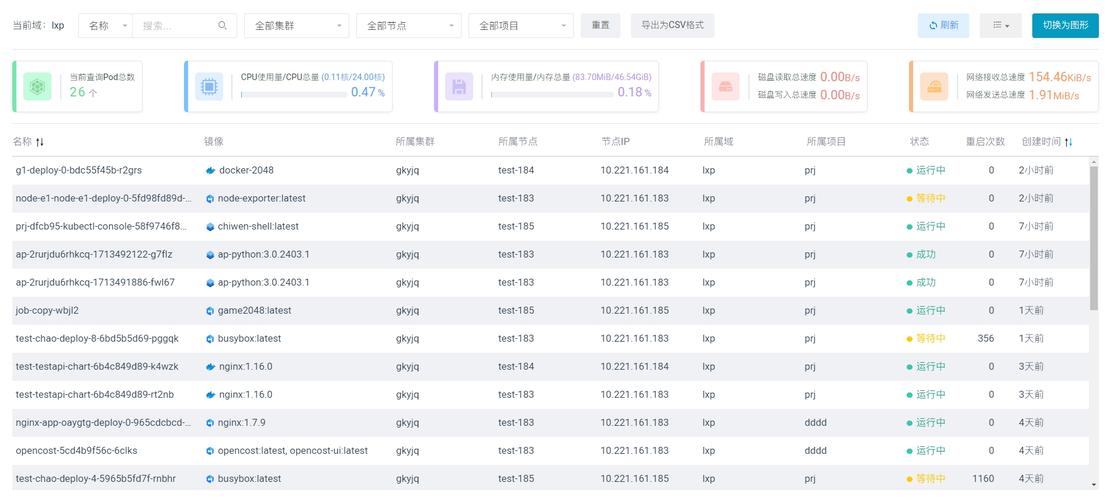
我们的做法是把控制面统一到一个 GitOps 仓库,配置全部声明式提交,谁改了配置、什么时候改的,commit 记录里查。密钥不落在仓库里,走独立的密钥管理服务。集群之间的差异用 overlay 表达,公共部分继承。
这套东西搭起来前两周很痛苦,之后每次发布省下来的心力和时间,值。工具选什么其实次要,Argo CD 也好,Flux 也好。关键是别让任何人在控制台里手工点按钮改生产配置——那是混乱的起点。
还有个细节:时区和证书。跨区域的集群,NTP 不同步会导致 token 校验莫名其妙失败,这种问题排查起来能耗掉一整个下午。别问我怎么知道的。
成本分摊做不好就是一笔糊涂账
财务那边最怕听到的一句话是「这个月云账单又涨了,具体哪块涨的不清楚」。
混合云的成本结构比纯公有云复杂,因为有一部分在固定资产里,有一部分在运营支出里。老板看的是总盘,技术团队看的是资源,财务看的是科目,三边对不上。
能缓解的办法其实不复杂——打标签。所有资源上线时必须带业务、环境、负责人的标签,没有标签的不许创建。云厂商的账单导出加上资源标签,就能按业务线拆开。虽然标签这事推起来会有人嫌麻烦,但等到季度复盘要解释一笔六位数的支出时,你会感谢当初坚持下来的自己。
还有个反直觉的点:预留实例和节省计划不是无脑买。先把稳定运行三个月以上的负载挑出来,用监控数据说话,再决定承诺多少。买多了,等于把钱锁死在一堆用不上的额度里。
真想跑稳我建议先做这几件事
啰嗦了半天,说点能直接落地的。
先把跨云的调用关系画出来。哪些是同步、哪些能异步、哪些必须走专线、哪些可以走公网加加密。这张图不画,后面所有优化都是瞎猜。
再把运维边界写清楚。云上的安全组谁管,机房的防火墙谁管,出了故障第一个电话打给谁。混合云最容易出事的地方不是技术,是两拨人隔着一条线互相等对方。
然后给关键链路设一个延迟预算。比如登录接口不许超过 300 毫秒,超了就告警。有了预算,架构讨论才有依据,不然永远是「我觉得」「我感觉」。
最后,接受一个事实:混合云不是过渡状态,对不少公司来说它就是长期形态。别老想着哪天彻底统一,先把接缝处的毛刺磨平。
老周后来把签名改了,改成「边界清楚,各管一段」。我觉得比原来那句强。