凌晨两点十七分,支付接口错误率从0.3%跳到11%。值班群一下炸了。有人贴Kibana截图,有人翻Prometheus曲线,还有人问:是不是刚发的版本?十五分钟过去,唯一确定的事情是,没人知道到底哪里坏了。
这不是工具不够。恰恰相反,那支团队有指标、有日志、有链路,甚至有三个看板。问题是它们各说各话。指标看板说CPU正常,日志里全是超时,链路却把矛头指向一个谁都没听说过的下游缓存。对吧,这种场面太常见了。
告警越多 盲区越大
可观测性常被拆成三根柱子:Metrics、Logs、Traces。翻译成人话,指标告诉你系统现在怎么样,日志告诉你当时发生了什么,链路告诉你这一次请求到底经过了谁。听起来很清楚。真到故障现场,三根柱子经常变成三根电线杆,彼此不相连。
我最怕听到一句话:我们全量采集了。全量,不等于可观测。全量日志可能一天烧掉几十万,查询还要等半分钟;全量Trace可能把采样率开到100%,结果网络出口先崩。更麻烦的是标签。团队A用service_name,团队B用app,团队C把Pod名字塞进指标标签,基数一炸,Prometheus直接给你脸色看。
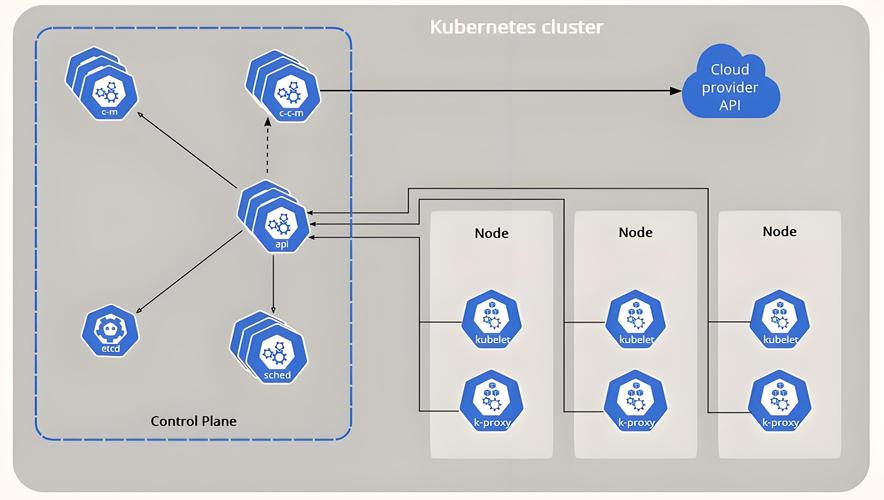
所以第一件事不是加工具,是把关联补上。每条日志带TraceID,每个Trace带服务名、版本、环境、租户,每个告警带一个能点进去的查询链接。这个动作很小,但故障时能省掉半小时的人肉拼图。
别把可观测性做成数据沼泽
云原生环境变化太快。Pod一会儿起一会儿灭,服务版本一天发五次,节点扩缩容像呼吸。传统监控里那种给每台机器画一张静态图的思路,到这里会累死人。你需要的是动态标签和统一语义。OpenTelemetry火,不是因为它时髦,而是它至少想让不同语言、不同框架吐出来的数据有一个共同格式。不过话说回来,上了OpenTelemetry也不自动等于治理好了。标签命名仍然要靠人拍板。
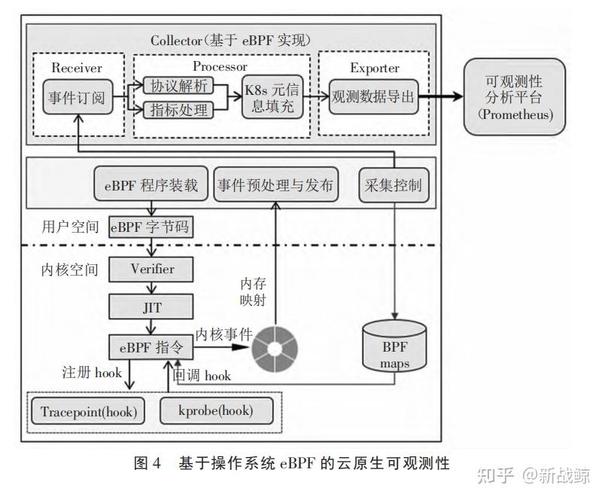
我们帮一个团队做过梳理。他们有两百多个服务,告警每天两千条。真正被处理的不到三十条。剩下的呢?淹没了。后来只做了三件事:按SLO重新分级告警,只有影响用户的关键路径才叫醒人;给每个服务补负责人和Runbook;日志指标链路统一用service.name和deployment.environment。两个月后,告警量降到一百多条,MTTR少了四成。没有换供应商。只是把噪声拧干了。
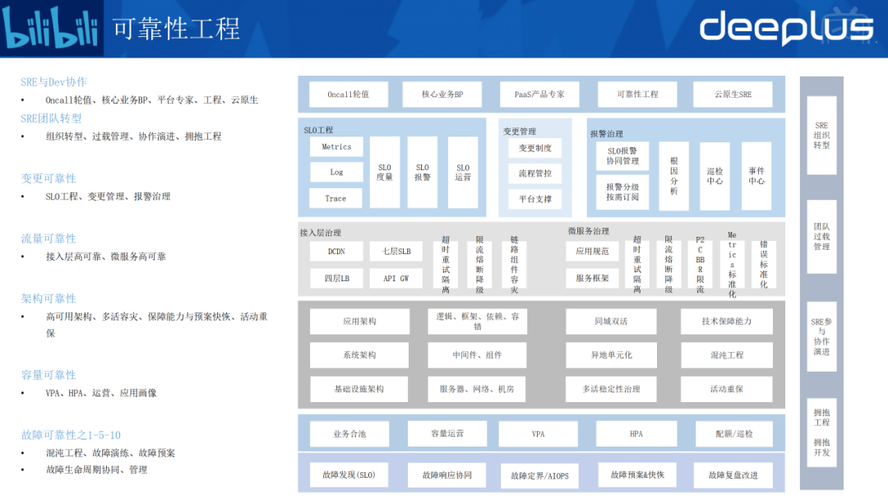
这里有个边界:如果公司只有十来个服务,别急着上全套可观测平台。一台好用的日志服务器,加上值班手册和复盘习惯,可能更实在。云原生不是规模崇拜。工具要跟着故障半径走,不是跟着技术热词走。
落地先回答三个土问题

我习惯在方案评审时问三个问题。谁在半夜被叫醒?故障发生时,他第一眼该看哪个页面?看完这个页面,他能不能定位到服务、实例、版本和租户?如果答不上来,再漂亮的架构图都是壁纸。
具体怎么动?别搞大爆炸。挑一条核心链路,比如支付、订单、登录。把这条链路的黄金信号先补齐:延迟、流量、错误、饱和度。注意,是核心链路,不是所有链路。然后让每个团队认领自己的服务标签,谁的服务谁维护。告警必须带Runbook链接,否则不许发。每周花二十分钟,砍掉一批没人处理的告警。每次事故复盘,不只写根因,还要写这次缺了哪个观测点。把它补进下一轮迭代。
还有一点容易忽略:可观测性不是SRE一个团队的事。开发不埋点,运维只能猜。测试不提观测需求,上线就是盲盒。我们见过最有效的一招,是在需求评审里加一列:这个功能上线后,故障时我们靠什么发现、靠什么定位?不要求填得多完美,但空白的需求,得有人解释为什么。
回到开头那个支付故障。后来复盘发现,根因是一个缓存客户端版本升级后,连接池配置没跟上。真正耽误时间的,不是修复,而是确认。指标、日志、链路各自都有线索,但没人把它们串起来。可观测性体系建设,说到底就是让故障时的每个人少猜一点。少猜一点,夜里就能少醒一次。就这样。