上周在南京珠江路的一家小馆子,和做零售数据的老陈拼桌吃饭。
他掏出来皱巴巴的报销单,说去年砸在两套数据系统上的钱,快抵得上整个部门半年的服务器采购预算。之前他团队一边用数据湖存全量的用户行为日志,一边用传统数仓跑结构化的销售报表,两边的同步链路每个月都要断个三四次。同一份用户画像,数仓算出来的月均消费是286块,湖那边跑出来是312块,两边的算法工程师拉了三小时会,最后发现是两边取数的时区差了八小时。
就这种破事,每周都在发生。
两套系统的内耗比你想的更磨人
没人喜欢当跨系统的传声筒。
做实时数仓的同事要把湖里面的原始日志清洗成结构化指标,再倒回数仓给报表团队用;做算法的同事要把数仓里算好的用户标签导回数据湖,再喂给训练模型。整个链路全靠手动写的同步脚本撑着,哪天脚本漏跑一次,第二天的业务报表就得延迟两小时出。
这些跨系统的冗余同步成本,本质上是在为架构割裂交重复的智商税。
很多团队最初被湖仓一体的概念吸引,根本不是冲着什么技术先进性去的,纯粹是被这种无休无止的内耗磨怕了。
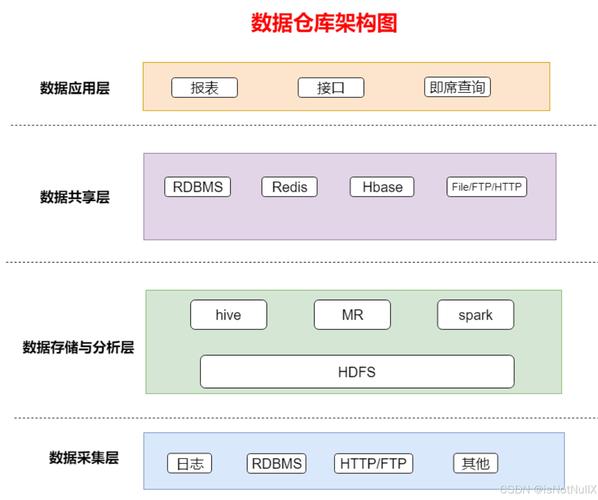
别把湖仓一体当出来的新名词
这事没那么玄。
最早湖仓一体的概念提出来,根本不是什么实验室里冒出来的革命性架构,就是厂商摸透了客户的痛点——既然大家被两套系统的割裂折腾得受不了,那干脆把存储、计算、权限这些能力往同一个引擎上凑,省得来回倒数据。
真没什么高深的。
不过话说回来,真落地的时候,坑一点不比原来的少。我见过太多团队上来就喊着”全面替换传统数仓”,把跑了五六年的旧系统直接停掉,把所有数据全迁到新的湖仓平台上。结果跑了两周发现,原来攒了上百个的业务SQL脚本,在新引擎上跑出来的财务报表全对不上——底层的字段类型转换逻辑变了,原来存成定点数的金额,在新引擎里直接转成了浮点数,几分钱的误差累积起来,整个月的利润表差了小二十万。团队连熬三个通宵补适配脚本,最后算下来花的精力,比维护原来两套系统还多。
湖仓一体从来不是”拆旧家搬新家”的一键迁移,而是要把过去十几年攒下的技术债,一笔一笔摊开理清楚。

算清楚落地的隐性成本再动手
厂商的PPT里永远只会写”存储成本下降30%””查询效率提升5倍”,没人会告诉你背后要补的隐性窟窿有多大。
你要搞湖仓一体,得有人能摸透原来数仓里所有的业务逻辑,得有人能把新的计算引擎的性能调优到生产可用的状态,得有人把原来散在两个系统里的权限、审计、数据血缘体系重新串成一条线。这些磨合的工作,没有个半年的周期,根本顺不下来。
我之前碰到过一个做制造的团队,跟风上了最新的湖仓引擎,结果原来用了好几年的BI工具连不上——新引擎的接口协议和老工具不兼容,最后又花了三个月改适配层,前后花的钱,比原来两套系统一年的运维成本还高。
亏不亏?
最忌讳的就是看着同行都上了湖仓一体,不管自己的业务实际情况就硬凑。比如你整个数据团队就三个人,日常需求就是拉个月度的销售统计报表,那根本没必要凑这个热闹,把原来的老数仓用顺了,比什么都强。
上次在南京的1024程序员聚会上,有个做工业互联网的工程师聊起他们的踩坑经历,说最开始搞湖仓一体,想把所有的设备传感器日志、生产工单、质检报告全存在同一个存储桶里,结果跑了半年发现,90%的冷数据和热数据存在一起,哪怕只是拉最近三天的质检记录,也要扫半天的存储块,查询性能比原来的传统数仓还慢。最后没办法,又把冷数据单独拆出来做归档,绕了一大圈,才回到最基本的存储分层逻辑。
从来没有放之四海而皆准的架构,只有适配自己业务节奏的取舍。
很多人聊湖仓一体,总爱扯什么下一代数据架构的终局,其实根本没必要。
说白了,它就是个解决实际问题的工具。要是你现在被两套系统的同步问题磨得受不了,算下来迁移的成本比每年交的”内耗税”低,那就动手搞;要是你现在的系统跑的好好的,没什么跨系统的硬痛点,那完全没必要跟着概念跑。
工具而已。
别被概念绑住。