湖和仓不是左右拼图
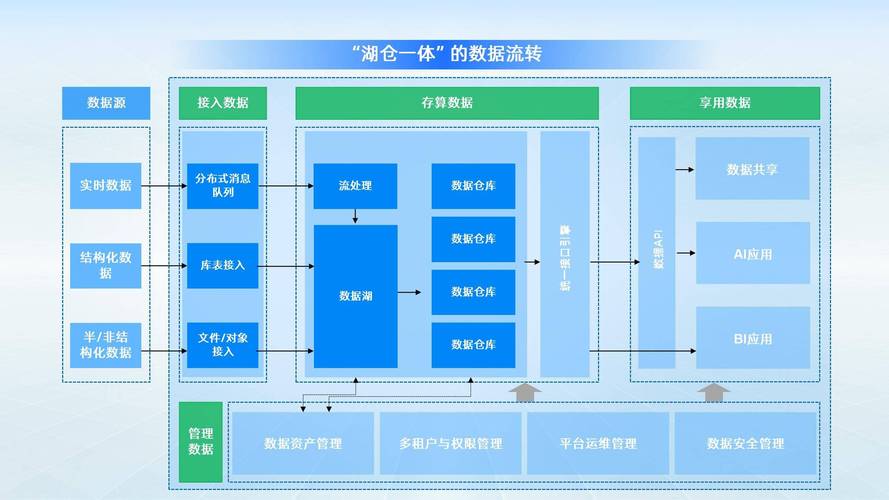
湖仓一体这四个字,第一次听挺唬人。听多了,就麻了。很多方案页一上来就是“一份数据,两种负载”。对。但落地不是画架构图。湖是文件,仓是表。中间隔着的不是一根数据管道,是元数据、事务、权限、血缘,还有账单。
过去做数仓,先建模型,再灌数据。做数据湖,先把东西扔进对象存储,后面再说。湖仓一体想同时要灵活和治理。技术支点主要是开放表格式。Iceberg、Delta Lake、Hudi,都算。它们让对象存储上的文件看起来像表。有快照。有 schema 演进。有分区变更。有事务日志。多个引擎读同一份数据,不用先搬运。
关键不是选哪个表格式,而是元数据服务能不能扛住并发。Hive Metastore 不是不能用。表一多,分区一多,跨引擎写入一多,锁和延迟就上来。catalog 一旦挂,整条链路都停。很多团队到这时候才发现,湖仓一体的单点不在存储,在 catalog。
还有小文件。流式写入最喜欢干的事,就是每分钟生成一堆小文件。对象存储按请求收费。查询引擎打开几千个小文件,启动开销比计算还大。compaction 得做。谁做?什么时候做?做的时候会不会影响写入?这些不是理论问题,是值班问题。
查询引擎越自由账单越难解释
湖仓一体经常宣传多引擎。Spark 跑批,Flink 写流,Trino 做交互查询,机器学习拉数据训练。听起来很顺。麻烦在于,每个引擎对同一个表格式的理解不一样。谓词下推、统计信息、快照隔离、分区裁剪,支持程度有差异。今天 Trino 跑得快,明天换个版本,计划变了,慢十倍。运维要背锅。
成本也是。对象存储便宜,说的是存储单价。GET 请求、LIST 请求、跨区流量,不便宜。尤其当分析师直接查原始数据,没物化视图,没本地缓存,每次扫描全量。开发爽了。月底账单来了,财务问这串数字是什么。你只能说,是自由的味道。
有个小案例。一个团队把离线报表迁到湖上,用 Trino 直查。开始很顺。后来报表数量翻了几倍,对象存储请求费涨得比存储费还快。他们加了物化视图,又给热点数据做本地缓存,才压住。代价是,原本以为不需要的数仓分层,又回来了。只是换了个地方做。

元数据是组织问题不是技术问题

湖仓一体让原始数据可查。好事。也是麻烦。以前脏数据在湖里,没人碰。现在 SQL 引擎直接挂上去,分析师一查,指标对不上。谁负责?数据源团队说,我只负责生产。平台团队说,我只管管道。分析师说,我只要结果。到了表格里多了一列“疑似口径”。
没有数据契约,湖仓一体就是给混乱加了一个高速入口。表谁拥有。字段变更提前多久通知。分区键能不能改。敏感字段怎么脱敏。行级权限、列级权限在文件级存储上怎么落。这些事,技术选型解决不了。得有人拍板,有流程,有工具。
血缘也变复杂。一个表可能有流式写入、批式回填、外部表映射、物化视图。一条查询背后跨了好几个引擎。出了错,排查路径比过去长。很多团队买了 catalog,却没建元数据备份和恢复演练。快照在,但 catalog 坏了,表就像不存在。这很尴尬。
小团队别急着全上
湖仓一体不是默认答案。数据量不大,团队人少,业务以 BI 报表为主,继续用成熟数仓更省心。对象存储做归档,偶尔查历史,也能过。真要上湖仓一体,通常得有几个条件:数据量到 PB 级别,或者增长很快;多个团队共用数据;需要流批一体;有 AI 训练和交互分析同时跑。缺一个,收益就打折。
代价要提前说清楚。catalog 要高可用。元数据要备份。引擎升级要做兼容性测试。小文件要自动合并。权限要统一。成本要打标签。查询要限流。哪一样没做,后面都会变成人肉运维。说白了,湖仓一体省的是搬运,不是省治理。它只是把治理挪到了更前面。
如果现在就要动手,先做三件事。选一个开放表格式,别同时押三个。把 catalog 的备份恢复演练跑通。找一条不痛不痒的业务链路试三个月。别一上来就换核心报表。出事的时候,你连昨天快照在哪都找不到,那就不叫湖仓一体,那叫湖仓一锅粥。