凌晨两点四十,手机在枕头边震。值班群里一条报警:订单查询接口 P99 飙到 4.8 秒。这种时候人的第一反应是什么?打开慢查询日志。对,但不是所有人都知道打开之后该看啥。
先搞清楚 慢的到底是谁
很多人一上来就 SHOW PROCESSLIST,看哪个线程跑得久。这招管用,但只能抓到此刻的。你要是晚起了十分钟,那条 SQL 早跑完了,你盯着一个空列表发呆。
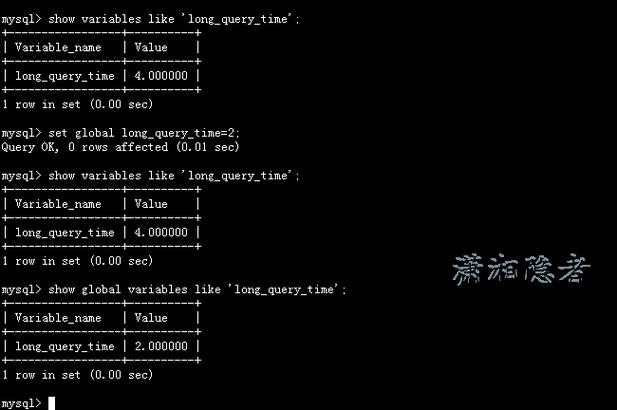
死磕慢日志才有戏。long_query_time 默认 10 秒,说实话这个值放在今天基本等于没有——线上接口超过 1 秒用户就开始骂人了。我一般调到 0.5 秒,再顺手开 log_queries_not_using_indexes。注意,后面这个开关很吵,索引选择性差的表天天刷屏,记得回头看,别让它把磁盘写满。
拿到日志之后别急着改 SQL。先把原语句丢进 EXPLAIN。看三个东西:type、rows、Extra。
type 是 ALL,那就是全表扫。rows 几百万?基本就是它了。Extra 里冒出来 Using filesort 或者 Using temporary,恭喜,排序和临时表在偷偷吃你的 CPU。
不过话说回来,MySQL 5.7 和 8.0 的 EXPLAIN 输出差别不小。8.0 有 EXPLAIN ANALYZE,能看到实际执行耗时,比估算出来的 rows 靠谱得多。有条件就上。
索引这东西 加错了比不加还糟
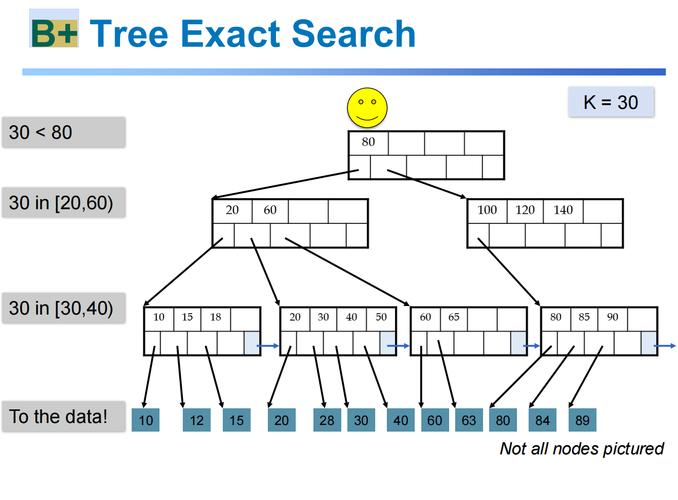
我见过太多次了。一条慢 SQL,开发同学手起刀落 ADD INDEX,第二天查询快了三倍,写入慢了五倍。为什么?因为每张表上的索引都要维护,B+树的页分裂、缓冲池的脏页,全是成本。
联合索引的字段顺序,更是个玄学。最左前缀原则大家都背过,真到写的时候——(a, b, c) 和 (c, b, a) 到底选哪个?我的经验是:等值条件放前面,范围条件放后面。一旦遇到范围查询,后面那个字段的索引就用不上了,白搭。
还有一种情况特别隐蔽:隐式类型转换。字段是 varchar,你传了个数字进去,MySQL 悄悄把字段转成数字来比较,索引直接失效。这种问题 EXPLAIN 也看不出来,得靠 SHOW WARNINGS 捞。
写 SQL 时 SELECT * 也是老毛病。回表这事,能覆盖索引就覆盖,尤其大字段表——你把一个 text 字段拖进来,IO 直接翻倍。
有些慢 根本不是查询的锅
说个反直觉的:慢查询日志里躺着的那条 SQL,未必是元凶。
我遇到过一次,一条看着很简单的 count 查询,稳定地慢。折腾了半天索引、执行计划,都没毛病。最后发现是连接池配小了,请求在排队,SQL 本身的执行时间只有 30 毫秒。所以啊——监控要多维度看,别只盯着 DB 这一层。
锁等待同理。innodb_lock_wait_timeout 默认 50 秒,一条 UPDATE 卡住,后面全堵在那儿。看 information_schema.innodb_trx,再配合 performance_schema 的等待事件,能挖出不少东西。

改完之后那半场 才是真功夫
优化不是改完 SQL 就完事。我的习惯是这几条:
上线前用生产量级的影子表跑一遍,别拿测试库那几千行糊弄自己;记录优化前后的执行计划并存档,三个月后有人再动这张表,还能对比;慢查询阈值不要一刀切,报表库和交易库的标准本来就该不一样。
还有一点,团队协作里最容易被忽略的:把结论写下来。不是写优化了索引,而是写清楚原来走哪个索引、改完走哪个、为什么。不然新人来了,又是一轮从零开始。
工具这块,Percona Toolkit 里的 pt-query-digest 值得装。几十万条慢日志丢进去,按总耗时排序,哪几条最该动手,一目了然。云上的话各家 RDS 自带慢日志分析也能用,就是颗粒度有时候差点意思。
最后说句实在的。慢查询定位这件事,八成靠的是对业务的理解,两成靠技术手段。你得知道这条 SQL 在业务上意味着什么,才判断得出它改不改、值不值得改。技术再花哨,方向错了都是白干。