上周跟做支付系统的朋友在南京路边摊撸串,他刚被生产事故追了三天。说出来有点好笑——大促前压测把网关限流阈值调高了两档,真爆量的时候,熔断规则没跟上,下游支付通道直接被打挂,整整四十分钟的订单全卡在提交页。
没人愿意吃这种亏。但翻遍网上的教程,全是原理框图,真到敲配置文件的时候,还是要踩一堆别人踩过的坑。
别把限流和熔断当同一件事
这事没那么玄。
限流本质是守自己的边界。就像写字楼早高峰的门禁,一次放三个人进,多的在楼下排队,别把电梯挤得动不了——它的作用是把进来的请求数,控制在自己系统能扛的范围内。
熔断是防故障传染。家里水管漏了,你第一反应是关总阀,别让水把整个地板泡了,等管道补好再慢慢开闸。它的作用是当下游服务出问题的时候,直接掐断流量,别让越来越多的请求堵在调用链上,把本来小的故障拖成全网瘫痪。
限流是守自身承载边界,熔断是防故障链式扩散。很多人配置的时候把两个规则混在一起,要么限流阈值设得比下游承载能力还高,要么熔断触发条件绑在限流规则上,最后哪个都没起到作用。
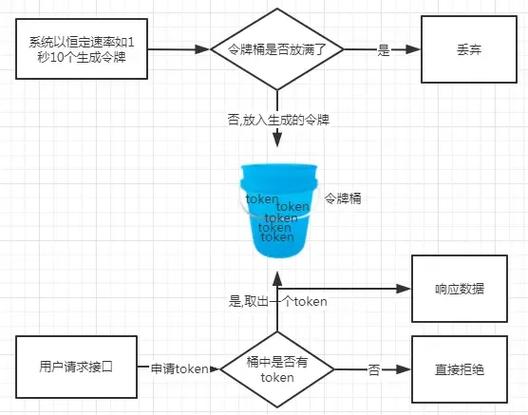
很多人上来就用默认的令牌桶算法,不考虑突发流量的缓冲空间。比如默认的桶大小设成100,令牌生成速度是每秒50,那突然来100个请求的时候,刚把桶里的令牌用光,后面的请求直接被拒,用户端直接看到报错。不是算法不对,是配置的时候没留够冗余——桶的大小至少要比日常峰值流量高30%,不然突发流量来的时候,缓冲池根本不够用。
拍脑袋定的阈值,比代码bug坑人
我见过最离谱的配置,是把所有接口的限流阈值统一设成2000QPS。
没有例外。
查询用户头像的静态接口、提交订单的核心接口、甚至后台的运维接口,全用同一个值。结果去年618的时候,爬虫薅头像接口薅走了近三分之一的额度,真正要付钱的用户,全被限流规则挡在外面。
麻烦在于,很多人定阈值的时候,只看压测出来的最大QPS,根本不考虑服务的冷启动过程。比如你压测的时候,服务已经跑了半小时,JVM预热完,数据库连接池拉满,QPS能稳在800。但实际生产环境,服务刚重启的头两分钟,QPS可能连200都到不了。你网关直接按800设阈值,前两分钟就能把刚启动的服务打挂。
不要用统一阈值覆盖所有接口。核心交易接口要按用户的实际请求量设,静态资源接口可以把阈值放高一点,但要单独加一层防爬规则,内部运维接口直接按IP白名单限流,别跟公网流量混在一起算。
还有个容易漏的点:限流的粒度。是按IP限?按用户ID限?还是按接口路径限?图省事全按网关整体QPS算的结果就是,某一个热门接口刷爆了,其他八竿子打不着的正常接口,跟着一起被限流。
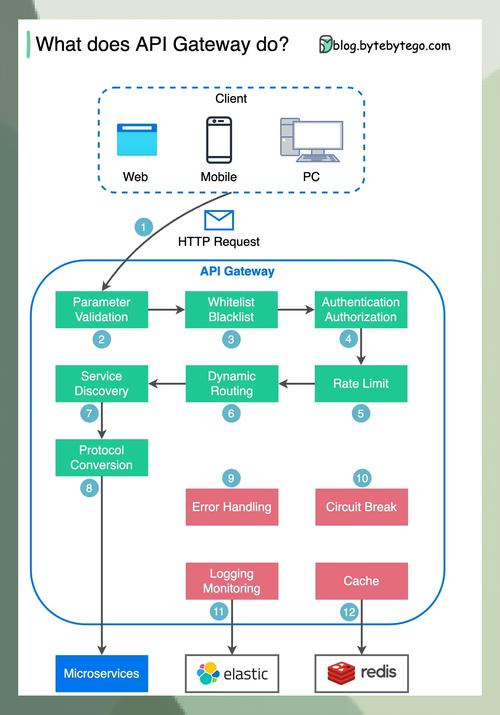
上次帮一个电商团队排查问题,他们的限流是按整体网关QPS算的。某次大促,一个新上的活动接口突然爆量,整体QPS冲到了阈值,结果本来正常的商品详情接口,有近20%的请求被直接拒绝。用户点不进去商品,直接关了页面走人,损失比那个爆量的接口还大。
熔断不是断了就完事,恢复期最容易掉链子
很多人觉得熔断配置简单,触发条件设个错误率超过50%,断个10秒,再放请求进来试,就完事了。
真不是。
我见过太多团队的熔断规则,断了之后就再也没恢复过。原因说出来特别可笑:半开状态下放出去的探测请求,刚好被下游的限流规则挡了,返回429。网关把这个429算成失败,又触发熔断,进入下一个10秒的断开周期。来回循环,直到人工上去手动把规则关掉。
这就是只盯着触发条件,没管恢复期逻辑的坑。
熔断恢复期的探测逻辑,比触发条件重要三倍。别只放一个请求进去试,多放两个——连续三个请求里有两个返回成功,才算下游真的恢复了。不然单个请求的偶发超时,或者被下游规则误拦,就会把整个恢复流程掐断。
还有,触发熔断的条件别只算5xx错误。下游返回的429、超时时间超标的请求,都要算进触发的统计范围。我之前碰到过一个案例,下游支付通道被上游的其他流量打满,开始返回429,网关的熔断规则只统计5xx,根本没触发熔断,最后通道直接被挤崩,所有请求全超时。
真的,别迷信官方文档里的默认配置。那些默认值是给测试环境用的,生产环境里,你得把每个参数都跟自己的下游服务对齐。
上周那个做支付的朋友,最后把规则全拆了重配。限流按接口粒度设,核心交易接口的阈值留了40%的冗余,熔断的触发条件加了超时占比,半开状态放三个探测请求。
上周的小促,系统稳稳扛过了峰值。他说再也不拍脑袋改配置了。